
GraphRAG může pomoci tam, kde odpověď vyžaduje projít vztahy mezi informacemi rozdělenými do více zdrojů. Neznamená to, že každé firemní vyhledávání potřebuje grafovou databázi. Nejdřív porovnejte stejnou sadu otázek s jednodušším řešením a připočtěte práci na získání, ověření a údržbě vztahů.
Rozhodnutí si ukážeme na skutečně spuštěném lokálním testu se sedmi syntetickými českými pasážemi. Porovnává jednoduché textové hledání, vztahovou expanzi a negrafovou kontrolu pomocí spojování záznamů. Neměří produkční Microsoft GraphRAG, Neo4j, embeddings ani generování odpovědí. Jeho hodnotou je průhledný mechanismus a viditelné neúspěchy, nikoli přenositelné procento přesnosti.
Rozlište hledání pasáže a otázku přes vztahy
„Kdy má služba servisní okno?“ může vyřešit jediný odstavec. „Na kterém úložišti závisí projekt přes službu, kterou používá?“ může potřebovat dva dokumenty: projekt používá službu a služba závisí na úložišti. Pokud první dokument neobsahuje jméno úložiště, samotné podobné znění otázky nemusí zajistit úplný důkaz.
Graf tento vztah uloží výslovně jako hranu mezi uzly. Uzel může představovat projekt, službu nebo dokument; hrana určitou vazbu, například „používá“. Průchod po hranách pak může dohledat další zdroj. Pořád ale záleží, zda jsou entity správně rozlišené, vztah skutečně doložený a použitelný v čase otázky. Špatná hrana jen rychleji zpřístupní špatnou souvislost.
Název GraphRAG navíc označuje více postupů. Microsoft ve své dokumentaci rozlišuje mimo jiné lokální hledání kombinující graf s textovými pasážemi a globální hledání nad vygenerovanými komunitními reporty. Globální varianta je v dokumentaci popsaná jako výpočetně náročná. Není totožná s každým dvoukrokovým průchodem vztahy.
Také knihovna Neo4j GraphRAG nabízí různé retrievery a odděluje vyhledávací komponentu od modelu vytvářejícího odpověď. Samotná přítomnost Neo4j v architektuře neprokazuje, že dotaz využívá vztahovou expanzi. Dokumentace byla pro tento text ověřena 18. listopadu 2026; uvedené produkty jsme zde nenasazovali.
Připravte jednoduchou negrafovou baseline
Baseline je výchozí varianta pro srovnání, nikoli záměrně pokažený protivník. U vlastního systému může být rozumným základem textové hledání s filtry, případně hybridní hledání. Azure AI Search popisuje hybridní dotaz jako souběh fulltextového a vektorového hledání se sloučením pomocí RRF. Grafovou expanzi k tomu nepotřebujete automaticky.
V naší malé fixture používá baseline ještě jednodušší pravidlo: počet společných slov otázky a pasáže po převodu na malá písmena a odebrání zapsané sady běžných slov. Shody se řadí sestupně, při rovnosti rozhoduje ID dokumentu. Vrací se nejvýše dvě pasáže. Nejde o BM25, lemmatizaci ani sémantické embeddings. Slabina takového základu omezuje závěr: test neukazuje, že by graf porazil dobře naladěné hybridní řešení.
Obě hlavní varianty dostaly stejné čtyři otázky, stejných sedm pasáží a stejný rozpočet dvou vrácených položek. Grafová větev navíc dostala ručně připravené vztahy a výchozí entitu otázky. Tato výhoda není zdarma: extrakci entity ani správnost hran test neřeší automaticky. Zachovat stejný počet pasáží je užitečné, ale neznamená to stejnou cenu přípravy.
Na úzkém displeji lze tabulku posunout vodorovně; klávesnicí po zaměření oblasti použijte šipky.
| ID | Pasáž |
|---|---|
| G1 | Projekt Javor používá službu Lumen. |
| G2 | Lumen závisí na úložišti Kamen. |
| G3 | Projekt Bor používá službu Delta. |
| G4 | Delta závisí na úložišti Oblak. |
| G5 | Lumen má servisní okno v úterý. |
| G6 | Projekt Javor používá službu Delta do října. |
| G7 | Úložiště Kamen podporuje export CSV. |
Grafová varianta provede nejvýše dva směrované kroky od zadané entity. Nejdříve vezme zdrojové pasáže účinných hran, zbývající místo doplní textovým hledáním a celek omezí na dvě položky. Není to naučený router. Expanze běží i u jednoduchých otázek, takže můžeme vidět i zbytečně přidaný podklad.
Udržte zdroj a čas každé hrany
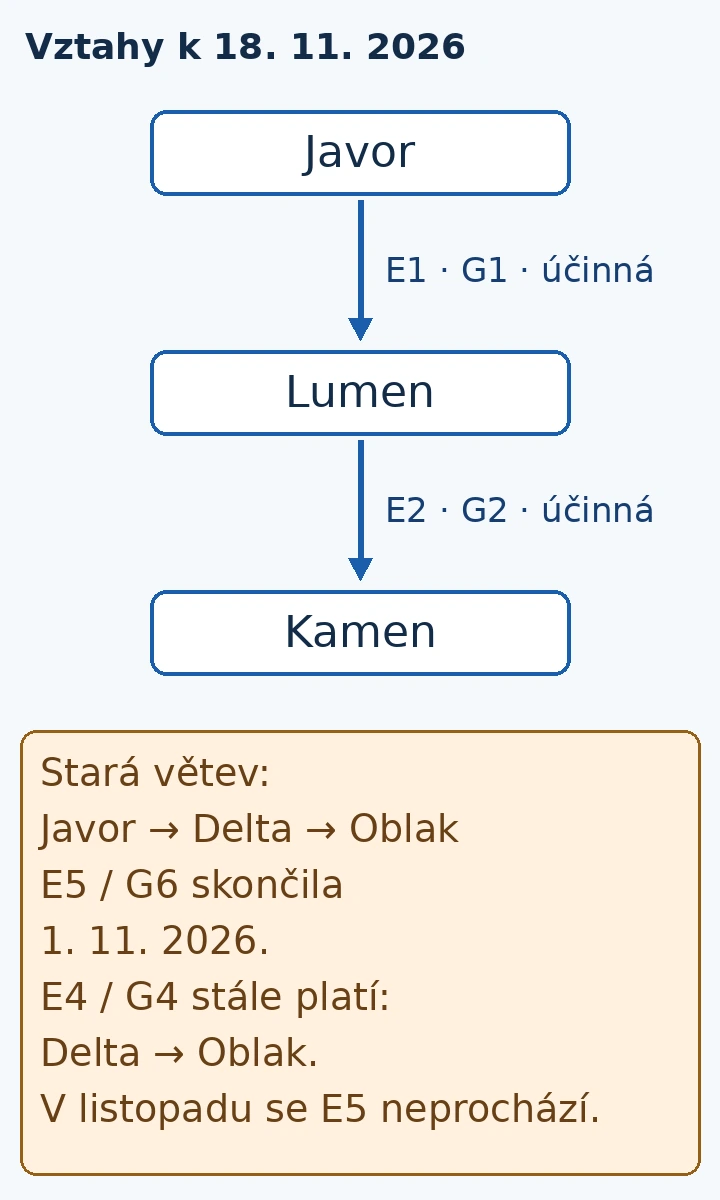
Hrana „Javor používá Lumen“ musí obsahovat víc než dvě jména. Pro tento test vedeme ID vztahu, zdrojovou pasáž a lokátor, typ vztahu, začátek a případný konec účinnosti, povolené role a původ anotace. E1 odkazuje na G1 a platí od 1. listopadu 2026. Starší E5 odkazuje na G6 a končí právě při začátku tohoto dne. E2 spojuje Lumen s Kamen, E3 Bor s Delta a E4 Delta s Oblak; tyto tři hrany jsou ve fixture účinné od 1. ledna bez zapsaného konce.
Ke dni 18. listopadu tak vede cesta Javor → Lumen → Kamen, zatímco větev Javor → Delta už není účinná. Filtr se musí použít na každou hranu průchodu, ne až na poslední dokument. Stejné pravidlo platí pro přístup: povolená první pasáž neodemyká další uzel. V této fixture jsou všechny hrany přístupné oběma modelovým rolím; rozdílné grafové ACL tím nejsou otestované.
U reálné extrakce uchovejte model či parser, jeho verzi a kontrolní stav hrany. Rozlišujte „zdroj výslovně tvrdí“ od „systém odvodil“. Dvě společnosti stejného jména neslučujte jen podle textového štítku. Pro odstranění vztahu potřebujete dohledat jeho původ a závislé odvozené výstupy. Bez této vazby je levný první import vykoupený drahou opravou.
Náš graf je autorsky připravená syntetická struktura, nikoli výstup LLM extraktoru nebo lidsky schválená firemní evidence. Nemáme proto změřenou přesnost extrakce. Následující porovnání záměrně odděluje účinek hotových vztahů od práce potřebné k jejich získání.
Porovnejte chyby, latenci a provoz
Před během byla ke každé otázce zapsána povinná sada důkazů. Úspěch znamená, že mezi nejvýše dvěma vrácenými pasážemi leží všechny požadované podklady. Nehodnotíme výslednou slovní odpověď. Pro vztahové otázky jsou potřebné dva zdroje, pro jednoduchou faktovou otázku jeden.
Na úzkém displeji lze tabulku posunout vodorovně; klávesnicí po zaměření oblasti použijte šipky.
| Otázka | Povinné zdroje | Textová baseline | Vztahová expanze | Negrafové spojení |
|---|---|---|---|---|
| R1: Na kterém úložišti závisí Javor přes svou službu? | G1, G2 | G1, G2 ✓ | G1, G2 ✓ | G1, G2 ✓ |
| R2: Na kterém úložišti závisí Bor přes svou službu? | G3, G4 | G2, G3 — neúplné | G3, G4 ✓ | G3, G4 ✓ |
| N1: Kdy má Lumen servisní okno? | G5 | G5, G1 ✓ | G2, G5 ✓ | G5, G1 ✓ |
| N2: Jaký export podporuje Kamen? | G7 | G7, G2 ✓ | G7, G2 ✓ | G7, G2 ✓ |
U vztahových otázek byla úplná sada v jednom ze dvou případů pro textovou baseline a ve dvou ze dvou pro expanzi. U nevztahových otázek obě metody našly potřebný jediný zdroj v obou případech. V R1 se baseline trefila i díky pravidlu pro shodná skóre. Kdybychom přejmenovali dokumenty, mohlo by se pořadí změnit. Tento malý příklad není statistický odhad kvality.
Negrafová kontrola používá stejnou tabulku vztahů, ale místo obecného průchodu provede dvě navazující spojení záznamů. V testu také získala všechny požadované sady. Takový postup lze vyjádřit i v relační databázi. Test tedy podporuje užitek explicitně spravovaných vztahů pro konkrétní otázku, ne nutnost grafové databáze. Výhoda se může změnit při složitějších cestách, větším objemu nebo jiných provozních požadavcích; zde to změřené není.
Zvlášť jsme zkoušeli poruchy grafu na R1. Po odstranění E2 zůstal výsledek úplný, protože chybějící zdroj doplnilo textové hledání. Když E2 chybně odkázala na G4, expanze obsadila rozpočet dvojicí G1 a G4 a důkaz byl neúplný. Bez časového filtru se do prvních dvou míst dostaly G1 a stará G6; potřebná G2 vypadla. Graf tak může dostupný správný kontext i vytlačit.
V zaznamenaném běhu jsme každou ze čtyř otázek opakovali 200krát pro každou variantu, tedy 800 měření na variantu. Medián samotného lokálního vyhledání činil u textového hledání 35,53 mikrosekundy, u expanze 39,65 mikrosekundy, u spojování záznamů 15,37 mikrosekundy. Tyto časy neobsahují přípravu indexu, síť ani generování. Nejde o latenci odpovědi asistenta a nejsou podkladem pro nákup serveru. Naměřená opakování sdílejí stejný malý proces a nejsou nezávislým vzorkem uživatelů.
V provozním rozpočtu evidujte zvlášť převod dokumentů, extrakci entit a hran, lidskou kontrolu sporných vazeb, aktualizaci, úložiště, dotazování i odpovědní model. Přidejte čas opravy chybné identity a vymazání zaniklých vztahů. Zde neuvádíme peněžní cenu: žádný placený GraphRAG systém jsme pro benchmark nespouštěli a náklady týmu nejsou známé.
Spustitelná syntetická ukázka v Pythonu
Zkopírujte celý kód do souboru ukazka.py a spusťte python3 ukazka.py. Stačí Python 3.10 nebo novější; kód nečte firemní data a nevolá síť. Hodnoty jsou modelové. Výpis zachová i záměrně vložené vady; časování závisí na stroji.
Delší řádky kódu lze posunout vodorovně. Klávesnicí přejděte na oblast tabulátorem a použijte šipky; celý kód kopírujte beze změny odsazení.
"""Syntetická ukázka; Python 3.10+, bez balíčků a sítě. Nejde o LLM benchmark."""
import json,copy,re,time,statistics
DATA = {'graph_documents': [{'id': 'G1',
                      'text': 'Projekt Javor používá službu Lumen.',
                      'entities': ['Javor', 'Lumen']},
                     {'id': 'G2',
                      'text': 'Lumen závisí na úložišti Kamen.',
                      'entities': ['Lumen', 'Kamen']},
                     {'id': 'G3',
                      'text': 'Projekt Bor používá službu Delta.',
                      'entities': ['Bor', 'Delta']},
                     {'id': 'G4',
                      'text': 'Delta závisí na úložišti Oblak.',
                      'entities': ['Delta', 'Oblak']},
                     {'id': 'G5',
                      'text': 'Lumen má servisní okno v úterý.',
                      'entities': ['Lumen']},
                     {'id': 'G6',
                      'text': 'Projekt Javor používá službu Delta do října.',
                      'entities': ['Javor', 'Delta']},
                     {'id': 'G7',
                      'text': 'Úložiště Kamen podporuje export CSV.',
                      'entities': ['Kamen']}],
 'edges': [{'id': 'E1',
            'from': 'Javor',
            'to': 'Lumen',
            'relation': 'používá',
            'source': 'G1',
            'locator': 'věta1',
            'from_date': '2026-11-01',
            'to_date': None,
            'roles': ['podpora', 'vedouci'],
            'extracted_by': 'explicitní autorská syntetická hrana; ne výstup extrakčního modelu',
            'review': 'autorská modelová anotace; nikoli člověk'},
           {'id': 'E2',
            'from': 'Lumen',
            'to': 'Kamen',
            'relation': 'závisí',
            'source': 'G2',
            'locator': 'věta1',
            'from_date': '2026-01-01',
            'to_date': None,
            'roles': ['podpora', 'vedouci'],
            'extracted_by': 'explicitní autorská syntetická hrana; ne výstup extrakčního modelu',
            'review': 'autorská modelová anotace; nikoli člověk'},
           {'id': 'E3',
            'from': 'Bor',
            'to': 'Delta',
            'relation': 'používá',
            'source': 'G3',
            'locator': 'věta1',
            'from_date': '2026-01-01',
            'to_date': None,
            'roles': ['podpora', 'vedouci'],
            'extracted_by': 'explicitní autorská syntetická hrana; ne výstup extrakčního modelu',
            'review': 'autorská modelová anotace; nikoli člověk'},
           {'id': 'E4',
            'from': 'Delta',
            'to': 'Oblak',
            'relation': 'závisí',
            'source': 'G4',
            'locator': 'věta1',
            'from_date': '2026-01-01',
            'to_date': None,
            'roles': ['podpora', 'vedouci'],
            'extracted_by': 'explicitní autorská syntetická hrana; ne výstup extrakčního modelu',
            'review': 'autorská modelová anotace; nikoli člověk'},
           {'id': 'E5',
            'from': 'Javor',
            'to': 'Delta',
            'relation': 'používá',
            'source': 'G6',
            'locator': 'věta1',
            'from_date': '2026-01-01',
            'to_date': '2026-11-01',
            'roles': ['podpora', 'vedouci'],
            'extracted_by': 'explicitní autorská syntetická hrana; ne výstup extrakčního modelu',
            'review': 'autorská modelová anotace; nikoli člověk'}],
 'graph_questions': [{'id': 'R1',
                      'kind': 'relation',
                      'question': 'Na kterém úložišti závisí Javor přes svou službu?',
                      'seed': 'Javor',
                      'date': '2026-11-18',
                      'required': ['G1', 'G2']},
                     {'id': 'R2',
                      'kind': 'relation',
                      'question': 'Na kterém úložišti závisí Bor přes svou službu?',
                      'seed': 'Bor',
                      'date': '2026-11-18',
                      'required': ['G3', 'G4']},
                     {'id': 'N1',
                      'kind': 'passage',
                      'question': 'Kdy má Lumen servisní okno?',
                      'seed': 'Lumen',
                      'date': '2026-11-18',
                      'required': ['G5']},
                     {'id': 'N2',
                      'kind': 'passage',
                      'question': 'Jaký export podporuje Kamen?',
                      'seed': 'Kamen',
                      'date': '2026-11-18',
                      'required': ['G7']}]}
def load(): return copy.deepcopy(DATA)
STOP = {'jaký', 'přes', 'má', 'kdy', 'kterém', 'na', 'svou'}
def tokens(s):return set(re.findall(r'\w+',s.lower()))-STOP


def active(e,q):return e['from_date']<=q['date'] and (not e['to_date'] or q['date']<e['to_date']) and 'podpora' in e['roles']


def lexical(q,docs):
 scores=[(len(tokens(q['question'])&tokens(d['text'])),d['id']) for d in docs]
 return [i for score,i in sorted(scores,key=lambda x:(-x[0],x[1])) if score>0][:2]


def expansion(q,docs,edges):
 frontier={q['seed']};seen=set(frontier);ids=[];visited=[]
 for _ in range(2):
  nxt=set()
  for e in edges:
   if active(e,q) and e['from'] in frontier:
    visited.append(e['id'])
    if e['source'] not in ids:ids.append(e['source'])
    if e['to'] not in seen:nxt.add(e['to']);seen.add(e['to'])
  frontier=nxt
 return (ids+ [i for i in lexical(q,docs) if i not in ids])[:2],visited


def join_control(q,docs,edges):
 # Relational adjacency joins need no graph database. Same authored relationships.
 if q['kind']!='relation':return lexical(q,docs)
 for e in edges:
  if active(e,q) and e['from']==q['seed']:
   for f in edges:
    if active(f,q) and e['to']==f['from']:return [e['source'],f['source']]
 return []


def graph_eval():
 f=load();docs=f['graph_documents'];edges=f['edges'];rows=[];times={x:[] for x in ['lexical','expansion','join']}
 for q in f['graph_questions']:
  selected={};visited=[]
  for mode,fn in [('lexical',lambda:lexical(q,docs)),('expansion',lambda:expansion(q,docs,edges)[0]),('join',lambda:join_control(q,docs,edges))]:
   for _ in range(200):
    start=time.perf_counter_ns();ids=fn();times[mode].append(time.perf_counter_ns()-start)
   selected[mode]={'ids':ids,'complete_evidence':set(q['required'])<=set(ids),'recall':len(set(q['required'])&set(ids))/len(q['required']),'precision':len(set(q['required'])&set(ids))/len(ids) if ids else 0}
  _,visited=expansion(q,docs,edges)
  rows.append({'id':q['id'],'kind':q['kind'],'question':q['question'],'required':q['required'],'selected':selected,'edges_visited':visited})
 ablations=[]
 for name,es in [('missing_E2',[e for e in edges if e['id']!='E2']),('wrong_source_E2',[dict(e,source='G4') if e['id']=='E2' else e for e in edges]),('stale_without_time_filter',[dict(e,to_date=None) for e in edges])]:
  q=f['graph_questions'][0];ids,visited=expansion(q,docs,es);ablations.append({'variant':name,'ids':ids,'complete_evidence':set(q['required'])<=set(ids),'edges':visited})
 return {'rows':rows,'timing_ns':{k:{'n':len(v),'median':statistics.median(v),'p95':sorted(v)[int(len(v)*.95)-1]} for k,v in times.items()},'ablations':ablations,'budget':2,'hops':2,'llm_calls':0,'embedding_calls':0,'graph_database':False,'edge_count':len(edges)}

print(json.dumps(graph_eval(),ensure_ascii=False,indent=2))
Rozhodněte podle úlohy, nikoli značky DB
Pokud převažují otázky na jednoznačnou pasáž a jednodušší řešení je na vašem vzorku zvládá, není graf automatický další stupeň vyspělosti. Nejdřív opravte chybějící metadata, české zkratky, filtry a výběr kontextu. Základy reprezentací vysvětlují vektory v SEO; spojování pořadí samostatně rozebírá RRF. Ani jedna metoda sama neověřuje platnost zdroje.
Grafovou větev pilotujte tehdy, když máte doložené opakované vztahové otázky, u kterých výchozí varianta ztrácí důležité důkazy. Stanovte povolené typy hran, maximální hloubku, rozpočet kontextu a správce aktualizací. Zkontrolujte, zda stejně dobře neposlouží řízený SQL dotaz nebo tabulkový join. Graf a relační model mohou mít různé provozní výhody; samotný obrázek s uzly mezi nimi nerozhodne.
Pro další porovnání potřebujete reálné otázky, nezávisle ověřené reference, kontrolu extrakce, opakované běhy a celý čas od dotazu po použitelnou odpověď. Zachovejte i neúspěchy. Zde chybí lidská doménová anotace, naučené embeddings, generování odpovědi, souběžná zátěž a produkční velikost dat. Přenos závěrů mimo sedm syntetických pasáží je proto otevřený, nikoli dokázaný.
Rozklad otázky na poddotazy, tedy query fan-out, může být další negrafovou možností, ale jeho použití také vyžaduje vlastní test. Přidávat současně graf, nový model i rozklad dotazu a pak celý rozdíl připsat grafu by nebylo poctivé srovnání.
Chcete ověřit, zda vztahy pomohou vašemu vyhledávání?
Pomohu vám vybrat otázky pro pilot, vymezit výchozí řešení a domluvit důkazy pro rozhodnutí o další investici. Napište mi, jaké souvislosti dnes lidé musejí ručně skládat z více zdrojů. Technologii zvolíme podle úlohy a provozu, ne podle předem slíbené převahy GraphRAG.