
AI rešerše je použitelná až tehdy, když se od každého důležitého tvrzení dostanete ke konkrétnímu místu v původním zdroji a ověříte jeho význam. Odkaz na PDF ani čas u videa sám nestačí. Potřebujete vědět, zda nástroj získal celý text, nerozbil tabulku a skutečně pracoval s obrazem, pokud na něm závěr závisí.
Následující postup je pro marketéra, analytika a autora odborného obsahu. Používá otevřenou studii o jazykových modelech a dva přesně vybrané snímky otevřeného animovaného filmu. Nejde o medicínskou demonstraci, benchmark rešeršního chatbota ani tvrzení, že proběhlo automatické porozumění celému videu. Ukážeme si hlavně to, co se při převodu dá ověřit a kde musí zůstat přiznaná mezera.
Rozlište text, sken, tabulku a obraz
Soubor PDF není jedna homogenní vstupní jednotka. Může obsahovat výběrový text, stránky tvořené obrázkem, tabulky s různými vztahy buněk i grafy. Obyčejná textová extrakce umí získat slova, ale nemusí zachovat pořadí sloupců, vazbu hodnot na záhlaví nebo informaci vyjádřenou pouze křivkou. OCR je rozpoznání znaků z obrazu; ani úspěšně rozpoznané věty nejsou automaticky správná struktura tabulky.
Nejprve uložte původní soubor a jeho verzi. Spočítejte stránky, prohlédněte jejich druhy a zkontrolujte, zda se text opravdu získal. Prázdný výstup na stránce se skenem znamená chybějící textovou vrstvu, ne důkaz, že stránka nic neříká. Potřebnou stránku převeďte do obrazu a zpracujte vhodnou cestou. U tabulky kontrolujte konkrétní buňky včetně jednotek, desetinných znamének, poznámek a rozsahu záhlaví.
Pro ukázku byl 18. listopadu 2026 stažen vydaný článek Lost in the Middle: How Language Models Use Long Contexts od Nelsona F. Liua a spoluautorů. Publikace v TACL z roku 2024 má 17 stran PDF, číslovaných v časopise 157–173. Není to v této ukázce pouze nalezený preprint. PDF bylo skutečně otevřeno, extrahováno po stránkách a vybrané stránky vykresleny k obrazové kontrole.
Na fyzické straně 5, tedy tištěné straně 161, jsou zároveň tabulka 1 a graf 5. Textová vrstva u řádku Claude-1.3 (100K) obsahuje hodnotu Oracle 76,4 %. Automatický tabulkový extraktor v našem běhu oddělil desetinnou tečku: vrátil „764%“ a tečku na dalším řádku. Samostatné OCR téže stránky, záměrně převedené na obrázek, přečetlo v tomtéž poli „16.4%“. Obrazová kontrola originálu potvrdila 76.4%. Všechny původní výstupy byly zachovány; vadné řetězce nejsou opraveny potichu v surovém záznamu.
Na úzkém displeji tabulku posuňte vodorovně; po zaměření oblasti klávesou Tab použijte šipky.
| Model | Closed-book | Oracle |
|---|---|---|
| GPT-3.5-Turbo | 56,1 % | 88,3 % |
| Claude-1.3 (100K) | 48,2 % | 76,4 % |
Tohle není soutěž, který extraktor je obecně nejlepší. Je to konkrétní zjištěná chyba na jedné stránce v daném nastavení. Ani textová vrstva sama neověřuje tabulkový kontext; správný údaj zde potvrzuje až vazba na řádek, záhlaví a obraz. U finanční tabulky by podobná záměna mohla změnit rozhodnutí, přestože souhrn zůstane jazykově hladký.
Také způsob předání souboru aplikaci je podstatný. Aktuální dokumentace OpenAI pro file inputs odděluje zpracování podle typu souboru a rozhraní; u PDF pro modely se zrakovým vstupem popisuje text i obrazy stránek. To není důkaz, že libovolný chatbot při zadání URL použije stejné zpracování. V našem testu neproběhlo placené modelové API volání; zpracování PDF zajistily lokální nástroje a vybrané pixely byly samostatně prohlédnuty.
U videa oddělte přepis a vizuální důkaz
Přepis zachycuje řeč tak, jak ji rozpoznal člověk nebo nástroj. Nezaručuje správné jméno, číslo ani úplnost úseků. Především ale nedokazuje, co bylo na snímku: číslo na slidu, stav přepínače, gesto, zobrazenou tabulku nebo probíhající akci. Popisek videa je další samostatný zdroj, nikoli přepis ani záznam viděných pixelů.
Pro obrazovou část jsme zvolili film Big Buck Bunny, původní vydání 640 × 360 z archivu Blender Foundation; skutečný videosoubor má obraz 640 × 359 a délku přibližně 596,46 sekundy. Vyšší rozlišení, novější sestřih nebo jiný úvod mohou změnit časovou polohu. Proto je v pracovním registru uložen přesný soubor, jeho otisk a čas snímku. Neodkazujeme pouze na název díla.
Byly skutečně vytaženy a prohlédnuty snímky v časech 01:00 a 02:00. Na snímku 01:00 je vidět velký bílý králík s hlavou obrácenou vzhůru, obloha a větve stromů. Není na něm viditelný text. To podporuje tento úzký popis snímku. Nepotvrzuje to, co postava řekla, proč se tak zachovala ani co se stalo v předchozí minutě. Druhý snímek ukazuje tři stylizované zvířecí postavy v trávě; nejisté určení jednotlivých druhů zde pro výklad nepotřebujeme.
Zvuková stopa v souboru existuje, ale pro tuto ukázku nebyla přepsána ani posouzena poslechem. Neoznačujeme tedy film na základě dvou obrázků za němý a nevytváříme mu domnělý přepis. Závěr o celé scéně by vyžadoval prohlédnutí příslušného časového intervalu, ne jen izolovaného snímku. Stejně postupujte u školení: tvrzení „na slidu je tabulka“ vyžaduje obraz, tvrzení „řečník doporučil změnu“ vyžaduje ověřenou řeč a její kontext.
Práva byla ověřena na oficiální stránce projektu: obsah projektu je poskytován pod CC BY 3.0 s vymezenými výjimkami pro loga a další prvky. Požadované uvedení původu pro části filmu zní „(c) copyright 2008, Blender Foundation / www.bigbuckbunny.org“. V článku nepřebíráme snímky filmu ani jeho loga, pouze na něj odkazujeme a popisujeme kontrolovaný výsek. Otevřený přístup a oprávnění k dalšímu použití jsou dvě otázky; u jiného videa potřebujete ověřit obě.
Každému tvrzení přiřaďte stranu či čas
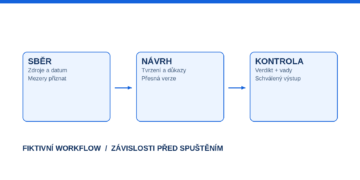
Vytvořte registr tvrzení, často označovaný jako claim ledger. Jeden řádek má obsahovat jeden ověřitelný výrok. Větu „studie prokázala zhoršení všech současných modelů a proto musíte přesunout text“ rozdělte: zjištění v experimentu, rozsah testovaných modelů a doporučení jsou tři různé věci. Jediná citace celé studie všechny tři automaticky nepodporuje.
U PDF zapisujte fyzickou i tištěnou stránku, číslo tabulky či obrázku a oddíl. U videa přesnou verzi a interval; samostatný snímek označte jako snímek. Připojte způsob přístupu: textová extrakce, OCR, obrazová kontrola, ověřený přepis nebo poslech. Záznam „zdroj přečten“ je příliš hrubý, pokud rozhodující údaj existoval pouze v grafu.
Na úzkém displeji tabulku posuňte vodorovně; po zaměření oblasti klávesou Tab použijte šipky.
| ID | Tvrzení | Lokátor | Stav |
|---|---|---|---|
| S1 | Vybrané otázky nad více dokumenty: 2 655 dotazů | PDF3 / tisk159, §2.1 | ověřeno v rozsahu studie; ne současný benchmark |
| S2 | Claude-1.3 (100K), Oracle 76,4 % | PDF5 / tisk161, tabulka1, řádek6 | ověřeno; surové chybné výstupy uchovány |
| V1 | Bílý králík s hlavou vzhůru, obloha a větve | 00:01:00.000, přesně uložená verze | ověřen jen viditelný snímek, ne příčina či řeč |
| V2 | Co bylo ve filmu řečeno | žádný ověřený přepis ani poslech | NEOVĚŘENO; netvrdit obsah řeči |
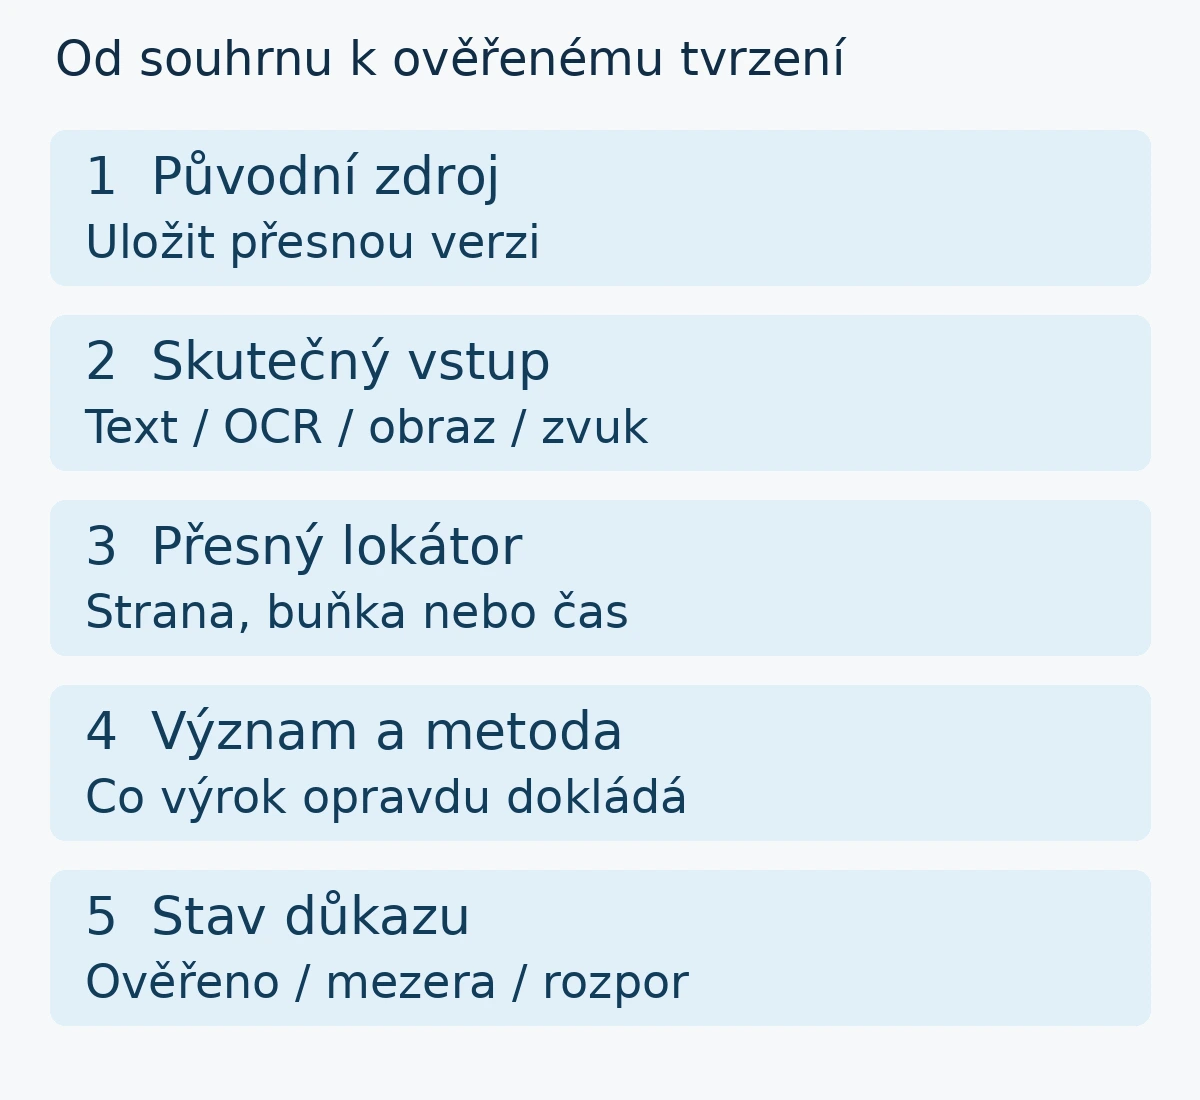
Prázdnou kartu si můžete zkopírovat do tabulky. Pole, pro která nemáte důkaz, nechte označená jako chybějící; nevytvářejte pravděpodobné stránky a časové značky zpětně.
- Identita tvrzení
- [ID; přesné znění; fakt, tvrzení autora, interpretace nebo doporučení; účel použití].
- Zdroj a verze
- [autor; název; vydavatel; URL; datum publikace; verze; datum přístupu; uložený originál a otisk].
- Lokátor a vstup
- [PDF strana / tištěná strana / oddíl / tabulka / buňka, nebo video od–do; text, OCR, obraz, přepis či poslech; skutečně zkontrolovaný rozsah].
- Ověření
- [podpůrná pasáž nebo popis obrazu; metodika; omezení; nesoulad extrakce; co tvrzení nedokazuje].
- Rozhodnutí
- [ověřeno v uvedeném rozsahu / částečně / rozpor / neověřeno; kontrolor; nutný další krok a vlastník].
Export do CSV nebo pracovního dokumentu má zachovat odkazy, české znaky, kvalifikátory i otevřené mezery. Tento typ evidence můžete vést mimo konkrétního chatbota; u interní práce zároveň respektujte pravidla ukládání dokumentů. V našem podkladu vznikl skutečný CSV export a kontrola jeho opětovného načtení, nikoli jen screenshot tabulky.
Porovnejte souhrn s metodikou a limity
U studie Lost in the Middle je podstatné, co výzkumníci měnili. V experimentu s otázkami nad více dokumenty pracovali s 2 655 vybranými dotazy NaturalQuestions-Open, jejichž delší referenční odpověď byla odstavec. Do kontextu vkládali jeden dokument obsahující odpověď a další rušivé dokumenty; měnili jejich počet a polohu relevantního podkladu. Metoda je popsána na tištěných stranách 159–160, testované modely na straně 161. Jiná část práce zkoumá syntetické vyhledání hodnoty podle klíče, nikoli stejné otázky.
Tabulka 1 na straně 161 porovnává režimy closed-book a oracle. V prvním model nemá dodané dokumenty, ve druhém dostane jediný dokument s odpovědí. Není to tabulka úspěšnosti podle polohy informace. Tu zkoumá sousední graf 5. Obrazová kontrola potvrdila jeho různé průběhy; přesné desetinné hodnoty bodů jsme z křivek neodhadovali. Vyšší hodnota Oracle není důkaz, že dnešní chatbot přečte všechno, co mu nahrajete.
Souhrn „dlouhý kontext nefunguje“ by zjednodušoval i vlastní závěry autorů. V oddílu 3.2 některé modely na syntetické úloze pracují téměř bezchybně. Oddíl 4.1 rozlišuje architekturu a délky známé z trénování. Dodatek A upozorňuje na časový nesoulad části Wikipedie s referenčními odpověďmi a uvádí doplňkový test nejednoznačnosti. Tyto části omezují interpretaci a nemají zmizet jen proto, že abstrakt nabízí chytlavý hlavní výsledek.
Publikace z roku 2024 používá tehdejší modely, mimo jiné GPT-3.5-Turbo ve verzi 0613 a Claude-1.3. Výsledek je důvodem testovat použití kontextu ve vašem systému, ne hotovým verdiktem o všech modelech v listopadu 2026. Přesné pořadí dnešních služeb jsme nezměřili. Stejně tak z práce neplyne univerzální délka odstavce pro SEO ani povinnost dát každou důležitou větu na začátek webu. Rozdíl mezi důkazem a marketingovým receptem rozebírají mýty o GEO a AEO.
Zaznamenejte chybějící části a stav důkazu
Výsledná rešerše má umět říct nejen „tohle jsem našel“, ale také „tuhle část jsem nezpracoval“. Uveďte nedostupné přílohy, stránky bez čitelného textu, neověřená čísla, úseky bez přepisu a grafy, které jste neprohlédli. Chybějící podklad není negativní výsledek studie ani důkaz, že ve videu něco nezaznělo.
V naší ukázce máme originální PDF, extrakci všech 17 stran, čtení hlavního textu a relevantních dodatků, konkrétní tabulkovou a OCR chybu i obrazovou kontrolu tabulky a grafu 5. Nemáme reprodukci původních modelových experimentů ani nový benchmark současných modelů. U filmu máme dvě přesně umístěné obrazové kontroly a ověřené licenční podmínky, nikoli přepis, poslech ani zhlédnutí celého filmu. Tyto hranice patří do podkladu stejně jako správné číslo z tabulky.
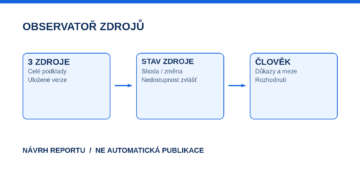
AI můžete požádat o návrh registru a vyhledání kandidátních pasáží. Připojte pokyn, aby oddělila přesné citace, parafráze a vlastní návrhy a označila chybějící vstupy. To je užitečné zadání, ne záruka správnosti. Ověření se vrací k originálu a závěr schvaluje odpovědný člověk. RAG umí dohledat podklady, ale samo dohledání ještě nepotvrzuje jejich výklad.
Při předávání autorovi připojte schválené výroky, jejich lokátory a zakázané interpretace do obsahového briefu. Pro následné psaní navazuje postup práce s AI obsahem. Rešerše končí použitelným podkladem a přiznanými hranicemi, ne povinně sebevědomou odpovědí na všechno.
Potřebujete rešerši, jejíž závěry půjdou zkontrolovat?
Pomohu vám nastavit zadání, práci se zdroji a kontrolu podkladů pro obsah nebo AI projekt. Napište mi, k jakému rozhodnutí dnes rešerši potřebujete. Rozsah odborné kontroly vymezíme podle tématu; do formuláře neposílejte neveřejné dokumenty. Souhrn bez ověřeného podkladu za hotovou analýzu vydávat nebudeme.