
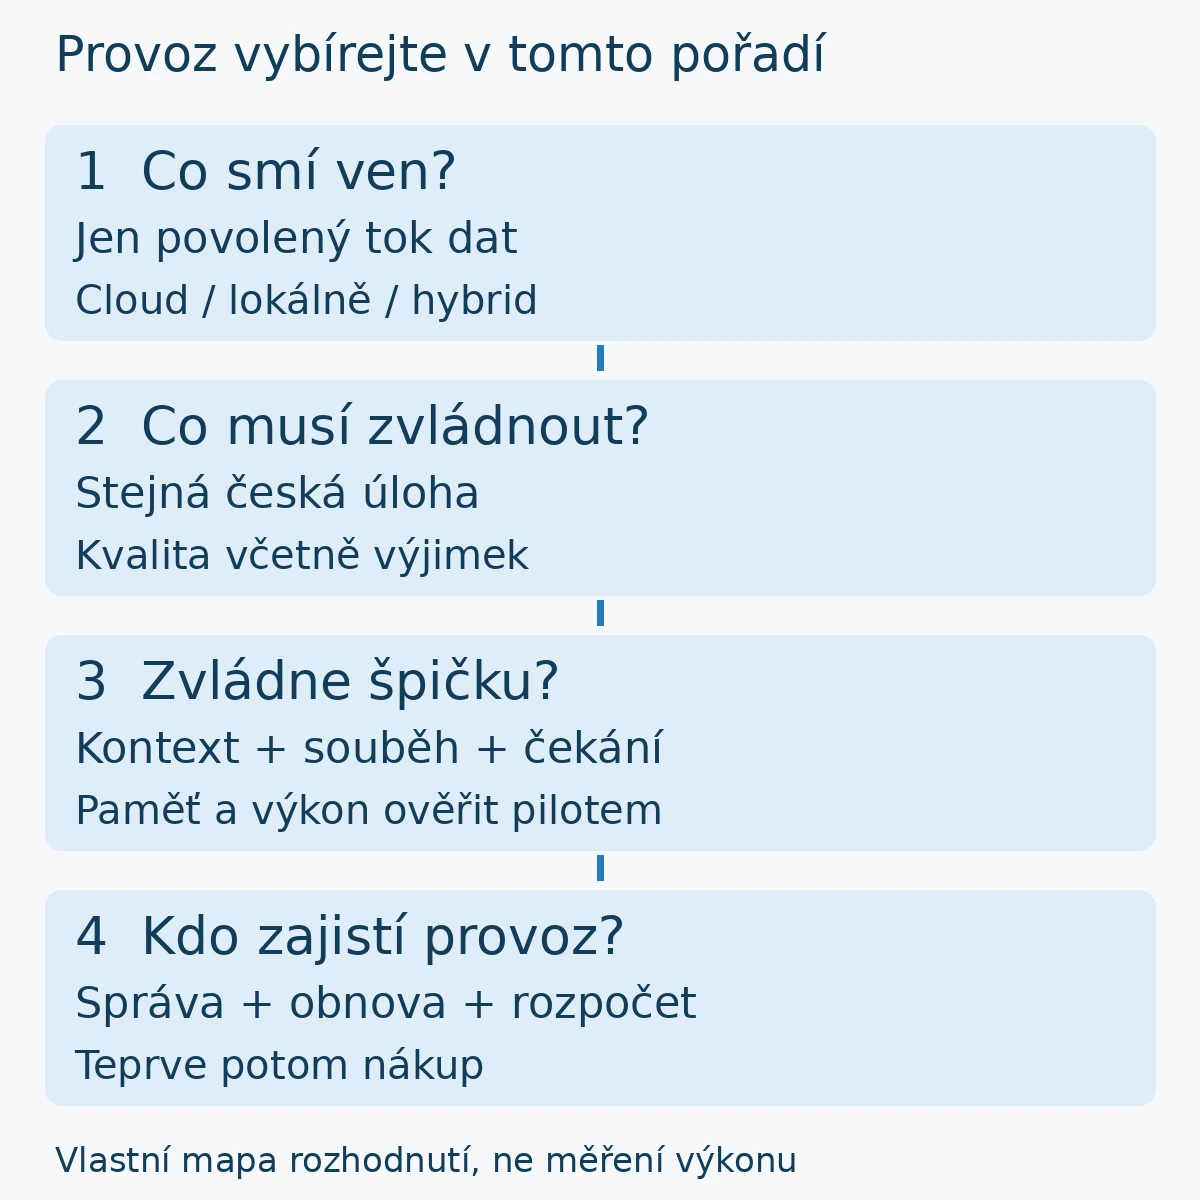
Cloud, vlastní model i hybrid mohou být rozumnou volbou. Rozhoduje, kam smějí data, jak kvalitní odpověď potřebujete a kolik práce systém zvládne ve špičce. Počet parametrů ani cena grafické karty na tyto otázky samy neodpovědí.
Začněte proto zadáním provozu, ne nákupním seznamem. Jeden člověk, který občas shrne veřejný dokument, potřebuje něco jiného než interní podpora s dlouhými podklady a několika současnými dotazy. Aplikace přitom může běžet na vašem počítači, zatímco samotný jazykový model zpracovává data u externího poskytovatele. „Máme to na vlastním serveru“ ještě nepopisuje celou cestu.
Tento článek je rešeršní rozhodovací podklad, nikoli vlastní inference benchmark. Dokumentaci a ceník jsem pro něj ověřil 18. 11. 2026; výkonová čísla níže pocházejí z výslovně označeného externího měření. Paměťové a nákladové příklady jsou spočítané modelové scénáře, ne výsledky našeho serveru ani nabídka dodavatele.
Určete, co smí opustit infrastrukturu
Nejdřív určete hranici: které vstupy smí zpracovat smluvně schválený poskytovatel a které musí zůstat uvnitř. Nehodnoťte jen finální dotaz. Vně může odcházet i převod skenu do textu, tvorba embeddings, obsah nalezených pasáží, diagnostické logy nebo zálohy. Lokálně spuštěný model nezruší externí krok před ním.
Pro veřejné produktové informace může být cloudový pilot praktickým začátkem. U důvěrných podkladů musí nejprve vlastník dat s IT a podle situace právníkem potvrdit povoleného zpracovatele, smluvní podmínky a přenosy. Citlivost sama není univerzálním zákazem cloudu; věta „dodavatel má evropský region“ zase není hotovým posouzením.
Rozdíl je vidět na pravidlech OpenAI API pro data. Poskytovatel uvádí, že je bez výslovného zapojení nepoužívá k trénování, současně ale standardně uchovává záznamy pro kontrolu zneužití až 30 dní, s uvedenými výjimkami. A některé funkce mají vlastní aplikační stav: například uložené objekty a soubory. „Netrénujeme na datech“ tedy neznamená „nic se nikde neuchovává“. Režim Zero Data Retention má podmínky schválení a omezení podle endpointu a funkce; není to vlastnost každého nového účtu.
Čerstvá dokumentace regionálního provozu uvádí Evropu jako EEA a Švýcarsko a rozlišuje uložení od zpracování. Podporované modely a režimy nejsou ve všech regionech stejné. Například GPT-6.1 Sol má podle současné tabulky evropské zpracování ve Standard, Flex a Batch; dostupnost jiného modelu nebo nástroje z toho neodvozujte. Systémová data mimo Customer Content mají výjimku z rezidence. U způsobilých modelů vydaných od 5. 3. 2026 ceník uvádí desetiprocentní příplatek za regionální endpointy. Před smlouvou ověřte dostupnost ve vlastním projektu; článek nepotvrzuje oprávnění konkrétního účtu.
Je-li externí zpracování nepřípustné, vyřaďte ho z návrhu dřív, než vybíráte model. Zůstává lokální řešení nebo jiná výslovně povolená infrastruktura. U vlastního provozu pak převezmete aktualizace, ochranu přístupů, zálohování i obnovu. Bezpečnost se nepřestěhuje do krabičky společně s modelem.
Vyberte reprezentativní české úlohy
Pro srovnání připravte stejné zadání, podklady a podmínky přijetí. Třeba odpověď na dotaz z interní směrnice, shrnutí českého dokumentu s výjimkou a extrakci několika polí do domluveného formátu. Přidejte situaci, kdy podklad odpověď neobsahuje. To jsou návrhy pilotních úloh, ne tvrzení, že zde proběhl test konkrétního modelu.
U každého případu napište očekávaný důkaz a chybu, která je nepřijatelná. Hezká čeština nezachrání ztracenou podmínku a správný formát JSON nepotvrdí správnou částku. Lidský hodnotitel má posoudit i terminologii, zdroj a to, zda má systém odmítnout odpověď. Vzorek by měl obsahovat běžné i dlouhé vstupy a obtížné případy, nikoli jen snadno předveditelné demo.
Protokol musí zachytit přesný model, revizi vah, kvantizaci, chatovou šablonu, nastavení generování a limit výstupu. U modelů s režimem uvažování zaznamenejte i jeho zapnutí. Jinak můžete nevědomky porovnávat krátkou přímou odpověď s dlouhým uvažováním. Podpora mnoha jazyků v model card není důkaz kvality na vašich českých dokumentech.
Pokud teprve hledáte uživatelskou aplikaci, navazuje přehled AI nástrojů. Zde řešíme jiné rozhodnutí: kde poběží inference a kdo za její provoz odpovídá. Základní práci s kontextem vysvětluje článek jak AI rozumí textu; pro dodání vlastních zdrojů je důležité také rozlišení RAG a samotného modelu.
Ověřte licenci, paměť vah a KV cache
Ke stažení není totéž co bez podmínek. U konkrétního Qwen3-8B model card uvádí 8,2 miliardy parametrů a licenci Apache 2.0. Ta obsahuje povinnosti zejména při redistribuci, zachování oznámení a označení změn. Nelze ji automaticky připsat všem modelům stejné značky. Podobně podmínky Gemma výslovně rozlišují modely uvedené v příloze od Gemma 4, pro kterou odkazují na jinou licenci. Kontrolujte konkrétní artefakt a zamýšlené použití, ne obecné slovo „open“.
Paměťový rozpočet tvoří váhy, pracovní paměť runtime, KV cache a rezerva systému. KV cache uchovává mezivýsledky pozornosti pro zpracovávané tokeny; s delším kontextem a dalšími souběžnými požadavky může výrazně růst. Velikost souboru na disku proto není velikostí celého běžícího systému.
Pro představu: 8,2 miliardy parametrů krát dva bajty v 16bitové reprezentaci dává přibližně 16,4 GB pouze na váhy. Ideální čtyřbitový přepočet vychází na 4,10 GB, ale skutečná kvantizace přidává další údaje a může měnit kvalitu. Ani jeden výpočet neurčuje potřebnou kartu nebo rychlost. GB jsou zde desetinné; následující GiB znamenají jednotky po 2^30 bajtech.
Konfigurace Qwen3-8B má 36 vrstev, osm KV hlav a rozměr hlavy 128. Pro jednoduchou plnou KV cache s dvěma bajty na hodnotu vyjde vzorec 2 × 36 × 8 × 128 × počet tokenů × počet nezávislých sekvencí × 2 bajty. Úvodní dvojka zastupuje klíče a hodnoty. Pro 8 192 tokenů a jednu sekvenci je to 1,125 GiB; pro čtyři sekvence po 32 768 tokenech už 18 GiB. Jde o analytický odhad bez sdílení prefixů, kvantizace cache, alokační režie a dalších optimalizací, nikoli měření spotřeby. Neplatí beze změny pro každou architekturu.
Model card rozlišuje nativní kontext 32 768 tokenů od prodloužení pomocí YaRN na 131 072. Delší podporovaný kontext neříká, kolik takových požadavků obslouží váš stroj. llama.cpp dokumentuje více hardwarových backendů, kvantizace i kombinovanou CPU/GPU inferenci. CPU tedy není obecně nepoužitelná možnost, ale její přijatelnost záleží na úloze a čekání. vLLM zase popisuje rozdělení modelu mezi GPU a odhad souběhu podle kapacity KV cache. Takový odhad není naměřená odezva pod zátěží. Volba runtime musí odpovídat skutečnému hardwaru a podporovanému modelu; zde žádný neinstalujeme.
Změřte souběh a cenu přijatelného výstupu
Souběh není počet zaměstnanců ani celodenní průměr dotazů. Pro budoucí firemní pilot připravte obvyklou zátěž a řízenou špičku. Sledujte dobu ve frontě, čas do prvního tokenu, čas hotové odpovědi, neúspěšné požadavky a paměť. Zapisujte rozdělení výsledků, například medián a 95. percentil s počtem pozorování. Test má zahrnout i běh bez zahřáté cache. Konkrétní cíle čekání a chybovosti dohodněte podle práce uživatele, ne podle líbivého čísla dodavatele.
Proč to dělat, ukazuje publikovaný benchmark Qwen2.5. V tabulkách pro Qwen2.5-7B-Instruct uvádí autor následující hodnoty. Jsou to starší externí výsledky dostupné při kontrole 18. 11. 2026; přesné datum samotného měření stránka neuvádí. Nejde o současný žebříček ani o měření výše rozebíraného Qwen3-8B.
Na mobilu tabulku posuňte vodorovně; po zaměření oblasti klávesou Tab použijte šipky.
| Runtime | Vstup (tokeny) | Výstup (tokeny) | Rychlost (tok/s) | GPU paměť (GB) |
|---|---|---|---|---|
| Transformers | 1 | 2 048 | 40,38 | 14,38 |
| Transformers | 30 720 | 2 048 | 18,83 | 19,97 |
| vLLM 0.6.3 | 1 | 2 048 | 84,28 | nevykázána |
| vLLM 0.6.3 | 30 720 | 2 048 | 70,33 | nevykázána |
Všechny čtyři řádky se týkají jedné NVIDIA A100 80GB, BF16, batch size 1 a generování 2 048 výstupních tokenů. U Transformers zdroj uvádí CUDA 12.1, PyTorch 2.3.1, Flash Attention 2.5.8 a Transformers 4.46.0; u vLLM verzi 0.6.3, PyTorch 2.4.0 a Flash Attention 2.6.3, se stejnou CUDA a Transformers. Výchozí nastavení vLLM je gpu_memory_utilization=0.9, max_model_len=32768 a enforce_eager=False. Paměť pro vLLM zdroj kvůli předalokaci nevykazuje.
U Transformers při delším vstupu roste vykázaná GPU paměť a klesá rychlost. Zároveň se při změně runtime mění čísla i na stejné kartě. To je užitečné varování před nákupem podle jediného údaje tok/s. Z těchto dat ale neznáme odezvu osmi současných uživatelů, kvalitu českých odpovědí ani čas do prvního tokenu. Neznáme ani výkon vašeho serveru. Chybějící hodnoty se nepřepočítávají prostým násobením.
Pro ekonomické srovnání použijte náklad na přijatý výstup: všechny náklady dané varianty za stejné období dělené počtem výstupů, které prošly domluvenou kontrolou. Do nákladů patří i neúspěšné pokusy, opakování a opravy. Pokud by z 1 000 pokusů prošlo jen 800, dělíte náklady 800, nikoli 1 000. To je vysvětlení jmenovatele, ne naměřená úspěšnost modelu.
Sečtěte administraci, monitoring a obnovu
Levnější token automaticky neznamená levnější službu. Celkové náklady vlastnictví, TCO, mají spojit pořízení a zprovoznění s průběžným provozem. Zahrňte také aktualizace modelu a runtime, monitoring, zálohy, kontrolu kvality a obnovu po výpadku. U vlastního stroje se nižší faktura za API může vyměnit za práci správce a odpovědnost za dostupnost.
Následuje průhledná rozpočtová ukázka v USD bez daní, kurzového přepočtu a financování. Jediným převzatým tarifem je OpenAI Standard pro GPT-6.1 Sol: 2 USD za milion vstupních a 10 USD za milion výstupních tokenů v krátkém kontextu. Počítám 20 000 požadavků měsíčně, každý s 6 000 vstupními a 1 000 účtovanými výstupními tokeny, bez cache, nástrojů, opakování a s evropským regionálním příplatkem 10 %. Výsledkem je (120 milionů × 2 + 20 milionů × 10) × 1,10 = 484 USD za tokeny. Není to cena předplatného ChatGPT ani odhad výkonu tohoto modelu.
Všechny další částky jsou zvolené modelové předpoklady, nikoli ověřené tržní nabídky nebo naše skutečná spotřeba. Pro lokální variantu volím pořizovací rozpočet 6 000 USD rozložený do 36 měsíců, 176 hodin měsíčně při průměru 0,20 kW a zbývajících 544 hodin při 0,04 kW. Při zvolené elektřině 0,25 USD/kWh to dělá 14,24 USD měsíčně. Správa zabere předpokládané čtyři hodiny po 50 USD a monitoring se zálohou 30 USD. Nejde o sizing konkrétního stroje a tento rozpočet nedokládá, že lokální model zvládne uvedený objem.
Cloudové variantě přiděluji dvě hodiny správy po 50 USD a 30 USD za provozní dohled. Hybrid má celý lokální provoz, 60 % požadavků do stejného API a dvě další hodiny správy směrování. Podíl 40 % lokálních požadavků je pracovní předpoklad, nikoli výsledek klasifikace nebo měření. Všechny varianty mají navíc společný měsíční základ 500 USD: 2 400 USD za základní zprovoznění rozložených do 12 měsíců, 100 USD za aplikační a vyhledávací vrstvu a čtyři hodiny lidské kontroly po 50 USD.
Na mobilu tabulku posuňte vodorovně; po zaměření oblasti klávesou Tab použijte šipky.
| Položka | Cloud API | Lokální | Hybrid 40/60 |
|---|---|---|---|
| Tokeny v EU API | 484,00 | 0,00 | 290,40 |
| Lokální hardware / 36 měsíců | 0,00 | 166,67 | 166,67 |
| Lokální elektřina | 0,00 | 14,24 | 14,24 |
| Správa varianty | 100,00 | 200,00 | 300,00 |
| Monitoring a záloha varianty | 30,00 | 30,00 | 30,00 |
| Společný základ | 500,00 | 500,00 | 500,00 |
| Součet | 1 114,00 | 910,91 | 1 301,31 |
Tabulka je výpočet při uvedených předpokladech, ne soutěž vítězů. Lokální varianta dosud neprokázala kapacitu ani stejnou kvalitu; hybrid zase neprokázal, že smí dané dotazy do cloudu poslat. Při modelovém snížení objemu na 2 000 požadavků klesne cloudový součet na 678,40 USD; při 200 000 vzroste na 5 470 USD. Tyto body pouze mění aritmetiku API a ostatní předpoklady drží stejné. Neříkají, že místní stroj takové objemy obslouží nebo že správa a kontrola zůstanou při růstu skutečně konstantní.
Před finálním rozpočtem nahraďte modelové položky cenovou nabídkou a výsledky pilotu. Doplnit může být potřeba migraci, síť a chlazení, náhradní kapacitu, pohotovost, bezpečnostní a právní práci, odlišný rozsah implementace, placené licence nebo častější kontrolu výstupů. Tabulka tyto položky samostatně neoceňuje. U kritického procesu si vyžádejte cenu i čas obnovy; jedna stanice bez náhrady není stejná služba jako provoz s domluvenou dostupností.
U hybridu vynuťte směrování mimo prompt
Hybrid funguje jen tehdy, když rozhodnutí o datové cestě nastane před odesláním. Instrukce „citlivé dotazy posílej lokálně“ nestačí, jestli ji má nejprve vyhodnotit cloudový model společně s citlivým textem. V tom okamžiku už data infrastrukturu opustila.
Použijte vynucenou politiku v aplikační vrstvě: povolený datový štítek a identita uživatele určí přípustné backendy, přístupový klíč dovolí jen danou cestu a síťová pravidla omezí odchozí provoz. Nejasný nebo zakázaný případ se zastaví či předá lokální cestě, ne automaticky „chytřejšímu“ cloudovému fallbacku. Přeneste omezení i na OCR, embeddings, nástroje a logy. To je návrh architektury k ověření, ne hotová bezpečnostní certifikace.
Před rozšířením pilotu uzavřete následující body:
- Kvalita: stejný český vzorek, známé správné podklady, očekávané odmítnutí a samostatný lidský hodnotitel.
- Kapacita: přesná verze modelu a runtime, kvantizace, délky vstupů i výstupů, špičkový souběh, fronta, první token, úplná odpověď a paměť.
- Data: povolené regiony, účet a smluvní režim, retence jednotlivých funkcí, celý tok včetně subdodavatelů a zakázané odchozí cesty.
- Obnova: vlastník aktualizací, sledování chyb, otestovaná obnova ze zálohy a postup při nedostupném backendu.
- Rozhodnutí: přijatelná chybovost a čekání, cena použitelného výstupu a předem určené podmínky pokračování nebo zastavení.
Pokud kandidát nesplní nepřekročitelnou podmínku, vyřaďte ho, i když má nižší cenu. Pokud splní vše podstatné, vybírejte podle celého provozu a možnosti změnit dodavatele. Právě tak se vyhnete nákupu, který je technicky působivý, ale neodpovídá práci vaší firmy.
Vyberte AI provoz podle práce, kterou má zvládnout
Rozhodujete se mezi cloudem a vlastním modelem? Pomohu vám ujasnit úlohy, hranice dat a kritéria pilotu, aby technický garant dostal srovnatelné zadání. Napište mi, co má AI ve vaší firmě řešit; citlivé podklady do kontaktního formuláře neposílejte.