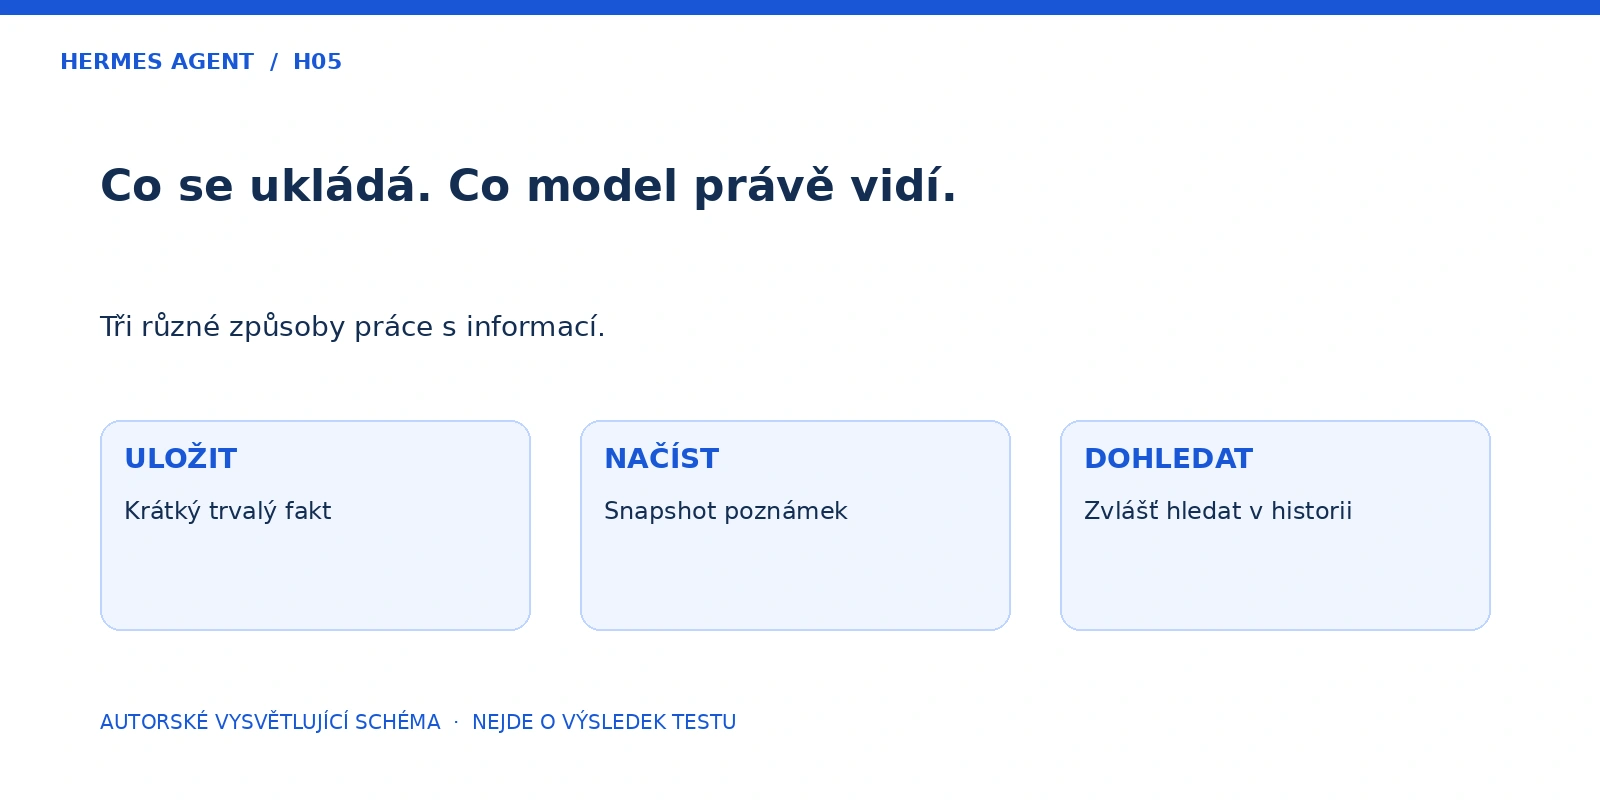

Když Hermes napíše „budu si to pamatovat“, ještě tím nic neuložil. Trvalou paměť je potřeba odlišit od právě otevřeného chatu i od archivu starších rozhovorů. Každá z těchto vrstev řeší jiný problém. Jakmile je přestanete zaměňovat, snáz zjistíte, proč agent něco neví a kde ověřit, zda se údaj skutečně zachoval.
Návod vychází z oficiální dokumentace ověřené 19. listopadu 2026. V době rešerše GitHub uváděl jako nejnovější vydání v0.23.2 z 16. listopadu 2026; průběžně aktualizovaná dokumentace ale není zmrazeným manuálem tohoto tagu. Popsané kroky proto před použitím porovnejte s nápovědou své verze. Výklad se týká již zprovozněného Hermes; není instalačním návodem pro Linux, macOS ani Windows. Ukázka níže je dokumentovaný postup s fiktivní preferencí, nikoli nově provedený test dvou konverzací.
Trvalá paměť je krátká poznámka, ne celý přepis
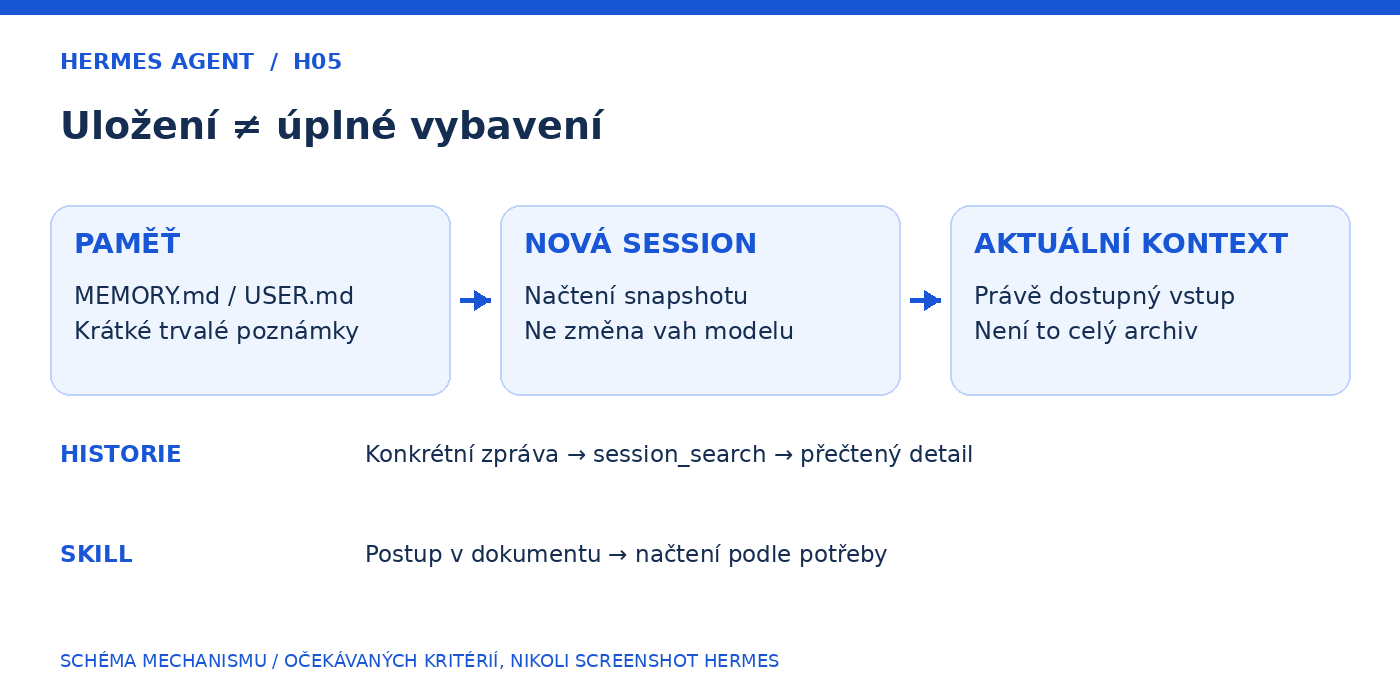
Základní paměť tvoří soubory MEMORY.md a USER.md v adresáři memories/ aktivního Hermes home. U výchozího profilu je to obvykle ~/.hermes/memories/. První soubor obsahuje kurátorské poznámky agenta, druhý informace o uživateli a jeho preferencích. Dokumentované výchozí limity jsou 2 200 a 1 375 znaků; lze je nastavit jinak. Nejde o velikost historie ani o počet tokenů, které model zvládne v jednom požadavku.
Do takto omezeného prostoru patří trvalý údaj, který má být užitečný i v dalších konverzacích. Například jazyk odpovědí nebo stabilní preference formátu. Podrobný postup pro kontrolu zdrojů je vhodnější uložit jako skill a rozpracovanou zakázku do projektového dokumentu. Pokud každou dokončenou úlohu proměníte v poznámku, paměť brzy zaplníte informacemi, které s dalším zadáním nesouvisejí.
Zápis poznámky nemění váhy jazykového modelu. Hermes uložený text předkládá modelu jako součást vstupu. Model se tedy může řídit novou informací, aniž by se tím přetrénoval. Stejně tak archiv rozhovorů není automaticky celý přítomen v každé odpovědi. Schopnost údaj uložit, najít a správně použít jsou tři samostatné věci.
Proč se uložená změna nemusí objevit v běžícím chatu
Oficiální dokumentace popisuje paměť vloženou do systémového promptu při začátku session jako frozen snapshot – zachycený stav. Zápis nástrojem se může ihned uložit na disk, tento počáteční blok ale nepřepisuje. Důvodem je stabilita prefixu pro cache modelu. Odpověď nástroje přitom ukazuje živý stav. Údaj může být dostupný také v dosavadním rozhovoru; není správné tvrdit, že po uložení nutně zmizí ze všech částí kontextu.
Pro diagnostiku proto oddělte dvě otázky: „Je změna uložená?“ a „Má ji tato session v počáteční paměti?“ Nová session si načte aktuální poznámky. U dlouhodobého chatu v komunikátoru však restart počítače nebo gateway nemusí znamenat nový rozhovor. Přirozenou hranici úkolu můžete vytvořit příkazem /new. Než to uděláte u rozpracované práce, uchovejte zadání, zdroje a další krok v předávacím dokumentu.
Dokumentovaný postup: dvě konverzace s fiktivní preferencí
Následující formulace jsou smyšlené testovací vstupy. Nepopisují Martinovy preference a nejsou důkazem chování konkrétního modelu. Zkoušku provádějte jen tam, kde smíte měnit paměť; nepoužívejte hesla, klientská data ani skutečné citlivé údaje. Pokud takové prostředí nemáte, můžete si pouze připravit kontrolní kritéria a nic nezapisovat.
- V první session zadejte: „Jde o dočasnou fiktivní zkoušku. Pomocí nástroje memory uložte do uživatelské paměti větu: Pro modelové ukázky preferuje uživatel označení Projekt Modřín.“ Kontrolujte skutečné volání nástroje a jeho odpověď, ne jen slovní souhlas.
- Ověřte přesné znění v
USER.mdsprávného profilu. Je-li zápis předložen ke schválení, ještě není aplikovaný. Nezaměňte připravený návrh za obsah souboru. - Po uložení začněte pomocí
/newnovou session a požádejte o označení modelového projektu podle uložené preference. Očekávaným kritériem je správný údaj z nového snapshotu, nikoli přesvědčivá věta „pamatuji si“. - Ve druhé session změňte fiktivní preferenci na „Projekt Lípa“. Požadujte opravu existující poznámky nástrojem
memory, nikoli přidání protichůdného druhého faktu. Ověřte soubor a následně novou session. - Na konci požádejte o odstranění dočasné testovací poznámky a ověřte její nepřítomnost. Odstranění poznámky samo o sobě nemaže původní zprávy z historie.
Výsledek si zapište jako vlastní pozorování až po provedení: datum, verze Hermes, profil, použitý model a provider, zda se uskutečnil zápis a co ukázala nová session. Pokud druhý chat odpoví správně, ale neověříte uložený soubor a profil, ještě nevíte, kterou vrstvou se údaj přenesl. Tento článek žádný takový dosažený výsledek netvrdí.
Historii hledejte podle konkrétního výroku
Pro otázku „Co jsme tehdy přesně dohodli?“ slouží nástroj session_search. Aktuální dokumentace jej popisuje jako vyhledávání uložených zpráv v SQLite s fulltextovým indexem FTS5 a možností procházet nalezenou session. Není to požadavek, aby agent odhadl obsah starého rozhovoru z několika slov v paměti. Dostupnost výsledku závisí také na tom, zda je příslušný záznam ve vašem úložišti zachován.
U fiktivní zkoušky požádejte: „Vyhledejte v historii přesné znění změny z Projektu Modřín na Projekt Lípa. Uveďte identifikátor session a místo zprávy, z něhož vycházíte. Pokud záznam nenajdete, řekněte to.“ Očekávaným kritériem je nalezená zpráva a její původ, nikoli domyšlená citace. Starší preference má být označena jako historická, ne znovu prohlášena za aktuální.
Podobný rozdíl mezi nalezeným podkladem a správným závěrem rozebírá článek Co je RAG a proč nalezený zdroj ještě není správná odpověď. U paměti je důležité navíc datum a platnost: nalezený starý výrok může být autentický, ale už nemusí platit.
Opravy a schvalování: nejdřív obsah, potom potvrzení
Nástroj memory podporuje přidání, úzkou opravu a odstranění položky. Oprava patch nahrazuje konkrétní úsek; není to volná instrukce přepsat vše. Pokud je paměť plná, zápis může selhat. V takové situaci má smysl zkrátit nebo sloučit neaktuální poznámky, nikoli bez kontroly přepisovat jiné platné údaje.
Nastavení memory.write_approval: true umožňuje schvalovat zápisy. Podle dokumentace se v interaktivním CLI zápis z popředí předkládá přímo, na dalších plochách a při běhu na pozadí se ukládá k posouzení. Příkaz /memory pending zobrazí čekající návrhy. Schvalujte konkrétní zkontrolovanou položku; hromadné schválení nesouvisejících změn není nutnou součástí testu. Brána se týká zápisů přes příslušný nástroj, není obecnou ochranou před libovolnou editací souboru.
Externí paměť vybírejte až podle skutečně chybějící funkce
Externí poskytovatel paměti může přidat jiné vyhledávání, modelování uživatele nebo zpracování konverzací. Jednotlivé integrace ale mají rozdílné ukládání, nástroje i provozní nároky. Aktuální dokumentace základní paměti navíc umožňuje vestavěné úložiště vypnout samostatně; z obecného popisu „externí paměť běží vedle základní“ proto nedělejte neměnné pravidlo pro každou konfiguraci.
Nejdřív pojmenujte, co základ nezvládá: potřebujete dohledat přesný historický výrok, spravovat mnoho měnících se faktů, nebo sdílet znalosti mezi více asistenty? Potom řešte, která data integrace odesílá, kam je ukládá, jak se opravují a odstraňují, kdo k nim má přístup a jaké vzniknou náklady. Přidání další služby neopraví neprovedený zápis ani hledání ve špatném profilu. Tento návod nevyžaduje zapnutí žádného externího provideru.
Zdroje a hranice ověření
Mechanismus paměti a schvalování: Persistent Memory. Diagnostika snapshotu a historie: Troubleshooting Agent Quality. Rozdíly integrací: Memory Providers. Verze: release v0.23.2. Zdroje byly ověřeny 19. listopadu 2026. Jde o rešeršně vedený návod; není to záznam nové instalace, inference ani vykonaného testu paměti.
Chcete nastavit, co si má AI skutečně pamatovat?
Pokud se vám mezi úkoly míchají preference, pracovní postupy a klientské podklady, pomohu vymezit, co patří do paměti a co do samostatné znalostní báze. Napište mi, kde při práci s AI ztrácíte návaznost. Pro začátek stačí popsat situaci, bez hesel a důvěrných dat.