
Než pomalému RAG asistentovi vyměníte model, změřte, kde čeká a za co skutečně platíte. Dlouhé hledání, přerovnávání výsledků, příliš velký vstup a pomalé generování vyžadují jiné zásahy. Cache může část práce odstranit, ale špatně navržená mezipaměť také vrátí staré pravidlo nebo odpověď určenou jiné osobě.
Tento postup je pro vlastníka běžícího asistenta a jeho vývojáře. Obsahuje skutečně spuštěnou malou lokální demonstraci časové osy, invalidace cache a ztracené výjimky. Pracuje se syntetickými dokumenty a obyčejnými textovými operacemi. Není to benchmark jazykového modelu ani případová studie úspory klienta.
Změřte ingestion, retrieval, reranking a generování zvlášť
Ingestion je převzetí a zpracování dokumentů: stažení, převod, rozdělení, případně vytvoření embeddingů a uložení indexu. Obvykle probíhá mimo jednotlivý dotaz. Pokud ale uživatel nahraje nové PDF a hned čeká na odpověď, patří tato práce do jeho čekání. U průběžně aktualizované báze sledujte vedle ceny importu také zpoždění mezi změnou zdroje a okamžikem, kdy se promítne do odpovědí.
Retrieval dohledá kandidátní pasáže. Reranking je následně přerovná; může použít další modelové volání. Pak se sestaví kontext, případně zkrátí, a teprve odpovědní model generuje text. Připojte i frontu před zpracováním, síť, opakované pokusy, kontrolu výstupu a doručení do rozhraní. Záznam pouze délky finálního API volání nepopisuje celou cestu.
Každému požadavku přidělte jeden identifikátor a podřízené úseky se začátkem, koncem a výsledkem. Uložte počty nalezených a předaných pasáží, skutečné tokeny podle odpovědi poskytovatele, použitý model a verzi konfigurace. Nezapisujte bez potřeby celé důvěrné dotazy. Pokud běží dva retrievery souběžně, jejich časy nelze prostě sečíst: uživatel čeká na kritickou cestu a příslušné čekání mezi kroky.
V naší ukázce se vytvořilo 1 200 modelových dokumentů a lokální slovní index. Dotaz našel jednu pasáž, výsledky se seřadily jednoduchým skóre a odpověď se složila z jejího textu. Nepoužíváme embeddingy, naučený reranker ani LLM. Import má vlastní časový počátek; následující waterfall začíná až přijetím dotazu. Mezery mezi pruhy zůstávají viditelné, protože režie měření není práce jednotlivých komponent.
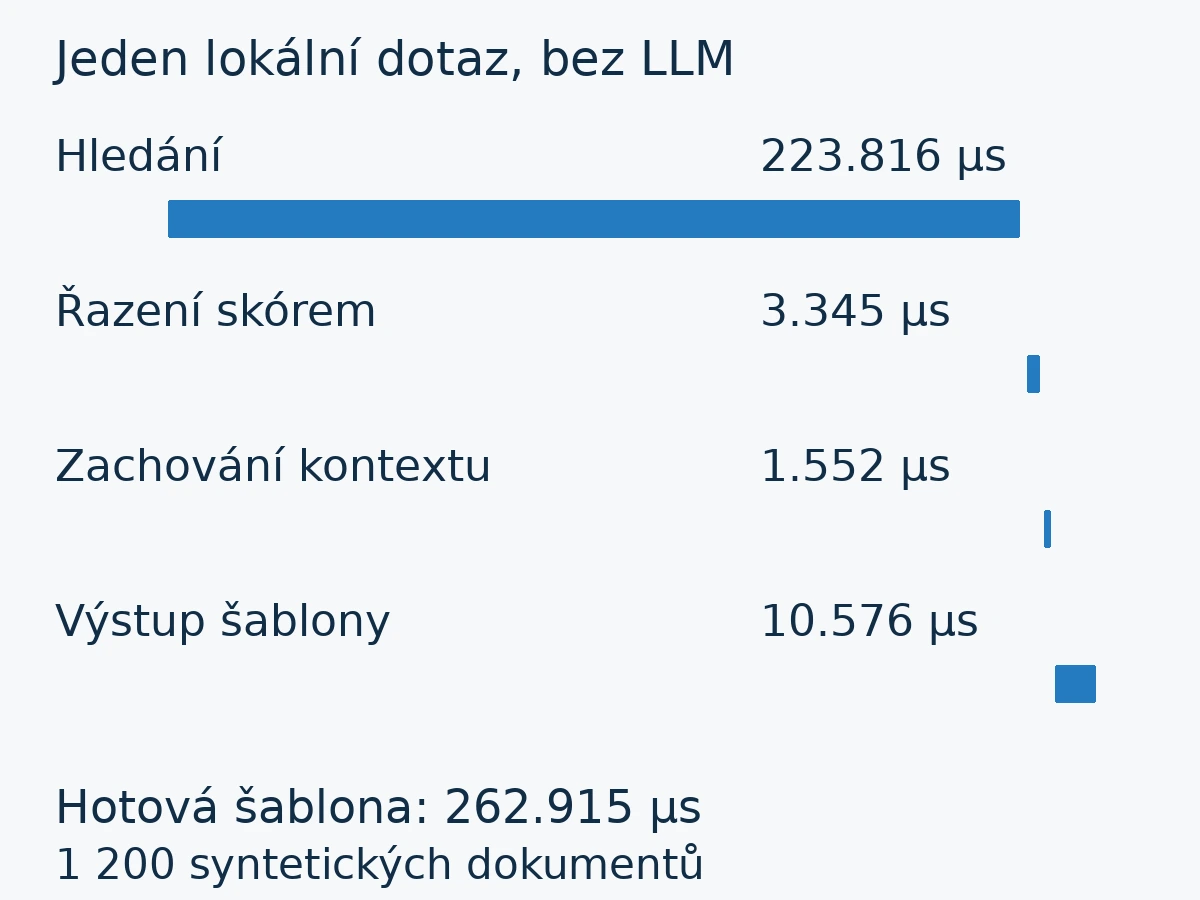
Na úzkém displeji tabulku posuňte vodorovně; po zaměření oblasti klávesou Tab použijte šipky.
| Fáze | Krok | Trvání (µs) |
|---|---|---|
| Příprava mimo dotaz | Vytvoření dokumentů | 1648,845 |
| Příprava mimo dotaz | Lokální slovní index | 3303,788 |
| Dotaz | Hledání | 223,816 |
| Dotaz | Řazení skórem | 3,345 |
| Dotaz | Zachování kontextu | 1,552 |
| Dotaz | Výstup šablony | 10,576 |
Jeden takový běh neukazuje stabilní rychlost serveru. Pro provozní rozhodnutí sbírejte srovnatelné požadavky při běžném i špičkovém zatížení, oddělte studený start od zahřátého provozu a sledujte rozdělení časů, chyby a nedokončené pokusy. Medián může být dobrý, i když část lidí čeká nepřijatelně dlouho. Zvolený percentil vždy doplňte počtem měření a složením úloh.
Počítejte cenu přijaté odpovědi
Rozpočet rozdělte na import a aktualizaci dat, vyhledávací infrastrukturu, jednotlivá modelová volání a lidskou kontrolu. Do ceny použitelné odpovědi započítejte i neúspěšné pokusy a opakování. Levnější generování, které způsobí více oprav, nemusí zlevnit dokončenou práci. Základy odlišení provozních metrik a obchodního výsledku rozebírají data v obsahovém marketingu; zde potřebujete navíc nákladový záznam každého průchodu aplikací.
Ilustrační kalkulace, nikoli provedené API volání: ceník OpenAI ověřený 18. listopadu 2026 uvádí pro GPT-4.1 mini ve Standard režimu 0,40 USD za milion vstupních tokenů, 0,10 USD za milion cachovaných vstupních tokenů a 1,60 USD za milion výstupních tokenů. Při zvolených 10 000 vstupních a 1 000 výstupních tokenech vychází samotné modelové volání na 0,0056 USD. Pokud je z téhož vstupu 8 000 tokenů skutečně vykázáno jako cachovaných a zbývající 2 000 nikoli, vychází 0,0032 USD. Výstup se v obou variantách účtuje. Nezahrnujeme daň, další nástroje, retrieval, sumarizační model ani práci lidí; použité tokenové počty jsou modelový předpoklad.
Aktuální sazbu a režim ověřte v primárním ceníku. Přepočet není příslib cache hitu ani důkaz zlevnění vašeho systému. U jiných modelů se může platit také zápis prefixu do cache; pravidlo jedné rodiny nepřenášejte na celý katalog.
Oddělte první token a úplnou odpověď
TTFT, time to first token, je čas do prvního výstupního tokenu modelu. Musíte ale říct, odkud měříte: od odeslání požadavku modelu, nebo od otázky uživatele v aplikaci. Druhá hodnota navíc zahrnuje předchozí hledání a další kroky. Zpráva „Hledám ve zdrojích…“ je stav rozhraní, nikoli první token odpovědního modelu.
Vedle TTFT ukládejte čas do celé odpovědi a případně do první užitečné informace. Ani to nejsou synonyma. Model může začít rychle prázdným úvodem a rozhodující podmínku napsat až na konci. U modelu s neveřejným uvažováním se navíc první interní výpočet nemusí rovnat prvnímu obsahu dostupnému uživateli. Definici proto vztáhněte ke skutečnému rozhraní a zaznamenaným událostem.
Streaming posílá obsah postupně. Může zlepšit orientaci uživatele, ale sám nedokazuje kratší dobu do hotové odpovědi ani nižší cenu. U návrhu, který ještě musí projít kontrolou, zvažte i to, zda smíte neověřené části ukazovat průběžně. Rychle zobrazená chybná rada není úspěšná optimalizace.
Naše fixture vrací obyčejné řetězcové části. Proto ve výstupu výslovně ponechává LLM TTFT a latenci úplné modelové odpovědi jako nezměřené. Naměřený čas do první části šablony nesmí dostat štítek TTFT. Je to kontrola instrumentace, ne náhrada skutečné inference.
Otestujte ztrátu významu při kompresi
Kontext lze zkrátit odstraněním duplicit, výběrem pasáží nebo sumarizací. Každá varianta ale potřebuje vlastní kontrolu věrnosti. Další sumarizační model má také čas a cenu; úsporu nezjistíte jen z menšího vstupu finálního modelu. Podmínky, zápory, jednotky a výjimky by měly být součástí testovací reference, ne první položky k vynechání.
Naše modelová pasáž zní: „Standardní doručení trvá dva pracovní dny. U zboží na zakázku se termín sjednává individuálně.“ Záměrně vadný kompresor ponechá jen první větu. Na dotaz ke zboží na zakázku pak chybí rozhodující výjimka. Test tuto ztrátu zachytí; kontrolní varianta zachová celý text. Nejde o změřenou chybovost LLM sumarizace: vadný zásah je předem napsané pravidlo a kontrola hledá známé výrazy.
V reálné regresní sadě nechte garanta posoudit význam, nejen přítomnost slov. Výjimka může v souhrnu formálně zůstat a přesto se připojit ke špatnému produktu. Uchovejte původní pasáž, komprimovanou verzi, konečný vstup a odpověď. Když se chyba objeví už v souhrnu, neřešte ji pouhým zvětšením finálního modelu.
Cache klíč svázejte s rolí a verzí
Nejdřív rozlište, co ukládáte. Cache výsledků hledání uchovává vybrané podklady. Cache hotových odpovědí může přeskočit i jejich nové sestavení. Prompt cache poskytovatele naproti tomu opakovaně využívá zpracovaný shodný prefix vstupu; není to knihovna dřívějších odpovědí na podobné otázky. Tyto vrstvy mohou mít různou retenci, oprávnění a invalidaci.
Dokumentace OpenAI popisuje shodu prefixu a modelově odlišné podmínky. Dokumentace Claude rovněž pracuje s prefixem a rozlišuje zápis a čtení cache. Ani jeden mechanismus neříká, že můžete bezpečně sdílet hotovou odpověď mezi uživateli jen proto, že jejich otázky mají vysoké skóre podobnosti. Skóre navíc není univerzální procento shody významu.
U aplikační odpovědní cache zahrňte tenant, oprávněného uživatele nebo přesně definovaný bezpečnostní rozsah, verzi práv, verzi použitých dat, časovou situaci otázky a verzi odpovědní konfigurace. Pouhá obecná role může být příliš hrubá: dva obchodníci nemusí smět ke stejným zákazníkům. Citlivý klíč nemusí obsahovat čitelný osobní údaj, ale musí jednoznačně oddělit povolené rozsahy.
Klíč nenahrazuje čerstvou autorizaci. Po odebrání přístupu nesmí starý hit obejít aktuální rozhodnutí. Při změně dokumentu potřebujete změnit verzi nebo zneplatnit všechny závislé odpovědi. Konec účinnosti podkladu může nastat dřív než nastavené TTL, tedy doba použitelnosti cache. A historický dotaz na říjen není stejný případ jako dotaz na dnešní pravidlo.
Na úzkém displeji tabulku posuňte vodorovně; po zaměření oblasti klávesou Tab použijte šipky.
| Změna | Očekávání | Výsledek |
|---|---|---|
| Stejný klíč, čas 11 | hit | PASS |
| Jiná role / uživatel / tenant | miss | PASS |
| Nová verze práv, dat či konfigurace | miss | PASS |
| Přístup nyní odebrán | bez odpovědi z cache | PASS |
| TTL: před hranicí 29, hranice 30 | hit / miss | PASS |
| Účinnost: před hranicí 24, hranice 25 | hit / miss | PASS |
| Explicitní invalidace | miss | PASS |
Spuštěných 19 kontrol zahrnuje vedle hitu změny identity, role, verzí a data, jiný dotaz, aktuálně odebraný přístup, přesné časové hranice, explicitní invalidaci a obě kompresní varianty. Všechny prošly. To dokládá chování této malé implementace, nikoli nulové riziko úniku v produkci. Podrobnou správu účinnosti a garantů řeší firemní znalosti pro AI; zde je cílem zabránit tomu, aby optimalizace jejich pravidla obešla.
Spustitelná lokální demonstrace v Pythonu
Zkopírujte celý kód do souboru ukazka.py a spusťte python3 ukazka.py. Stačí Python 3.10+, standardní knihovna, bez sítě a bez zápisu souborů. Časy se při dalším běhu změní; 19 kontrol ověřuje známé syntetické podmínky. Delší řádky lze posunout vodorovně.
"""Python 3.10+, standard library. Synthetic local pipeline, NOT LLM inference.
No network, sleeps, provider calls or CMS writes. Results are written to stdout only.
"""
import copy, hashlib, json, re, time, platform
from dataclasses import dataclass, replace

TEXT = 'Standardní doručení trvá dva pracovní dny. U zboží na zakázku se termín sjednává individuálně.'
@dataclass(frozen=True)
class Context:
    tenant: str = 'demo'
    user: str = 'u1'
    role: str = 'podpora'
    acl_version: int = 1
    corpus_version: int = 1
    model_version: str = 'template-v1'
    prompt_version: str = 'p1'
    compressor_version: str = 'full-v1'
    as_of: int = 50

def key(c, query):
    return (c.tenant,c.user,c.role,c.acl_version,c.corpus_version,
            c.model_version,c.prompt_version,c.compressor_version,c.as_of,query)

class Cache:
    def __init__(self): self.data = {}
    def put(self,c,q,value,now,ttl,valid_to):
        self.data[key(c,q)] = (value, min(now+ttl,valid_to))
    def get(self,c,q,now,authorized):
        # Authorization from the current caller, not a cached permission decision.
        if not authorized: return None
        item=self.data.get(key(c,q))
        return item[0] if item and now < item[1] else None
    def invalidate(self): self.data.clear()

def compress(text, mode):
    if mode=='bad': return text.split('. ')[0]+'.'
    return text

def preserves_exception(text):
    return 'zboží na zakázku' in text and 'individuálně' in text

def trace_run():
    # Deterministic documents; timing is measured, not deterministic.
    spans=[]
    def stage(name,fn,base):
        start=time.perf_counter_ns();result=fn();end=time.perf_counter_ns()
        spans.append({'stage':name,'start_us':(start-base)/1000,
                      'end_us':(end-base)/1000,'duration_us':(end-start)/1000})
        return result
    ingest_base=time.perf_counter_ns()
    docs=stage('ingestion',lambda:[{'id':str(i),'text':TEXT if i==777 else
        'Skladová informace '+str(i),'roles':['podpora','vedouci'],
        'version':1,'from':0,'to':100} for i in range(1200)],ingest_base)
    index=stage('index_local_words',lambda:[(d,set(re.findall(r'\w+',d['text'].lower())))
        for d in docs],ingest_base)
    ingestion=list(spans);spans=[]
    base=time.perf_counter_ns();query='zboží na zakázku';words=set(query.split())
    hits=stage('retrieval',lambda:[(d,len(ws&words)) for d,ws in index
        if 'podpora' in d['roles'] and d['from']<=50<d['to'] and ws&words],base)
    ranked=stage('rerank_local_score',lambda:sorted(hits,key=lambda x:(-x[1],x[0]['id'])),base)
    context=stage('compression_preserve_full',lambda:compress(ranked[0][0]['text'],'full'),base)
    parts=[];first_at=None
    # Ordinary string chunks are NOT model tokens. Do not label this metric TTFT.
    start=time.perf_counter_ns()
    for chunk in context.split(' '):
        parts.append(chunk)
        if first_at is None:first_at=time.perf_counter_ns()
    end=time.perf_counter_ns()
    spans.append({'stage':'template_output','start_us':(start-base)/1000,
                  'end_us':(end-base)/1000,'duration_us':(end-start)/1000})
    assert ' '.join(parts)==TEXT and preserves_exception(context)
    return {'ingestion_spans':ingestion,'query_spans':spans,
            'first_local_text_chunk_us':(first_at-base)/1000,
            'complete_local_text_us':(end-base)/1000,'TTFT_llm_ms':None,
            'llm_output_latency_ms':None,'production_cost':None,
            'output':context,'document_count':len(docs),'hits':len(hits),
            'scope':'synthetic lexical lookup, local sort, identity compression and string output; no embeddings/reranker model/LLM'}

def tests():
    c=Context();q='doručení';cache=Cache();checks=[]
    cache.put(c,q,TEXT,now=10,ttl=20,valid_to=100)
    def check(name,condition):
        assert condition,name
        checks.append({'id':name,'pass':True})
    check('same_key_hit',cache.get(c,q,11,True)==TEXT)
    for field,value in [('tenant','other'),('user','u2'),('role','externi'),
            ('acl_version',2),('corpus_version',2),('model_version','template-v2'),
            ('prompt_version','p2'),('compressor_version','short-v2'),('as_of',49)]:
        check(field+'_miss',cache.get(replace(c,**{field:value}),q,11,True) is None)
    check('new_query_miss',cache.get(c,'jiný dotaz',11,True) is None)
    check('revoked_authorization',cache.get(c,q,11,False) is None)
    check('ttl_before_boundary',cache.get(c,q,29,True)==TEXT)
    check('ttl_exact_expiry',cache.get(c,q,30,True) is None)
    cache.put(c,q,TEXT,now=10,ttl=90,valid_to=25)
    check('validity_before_boundary',cache.get(c,q,24,True)==TEXT)
    check('validity_exact_boundary',cache.get(c,q,25,True) is None)
    cache.invalidate()
    check('explicit_invalidation',cache.get(c,q,11,True) is None)
    check('bad_compression_caught',not preserves_exception(compress(TEXT,'bad')))
    check('full_compression_preserves_exception',preserves_exception(compress(TEXT,'full')))
    return checks

def main():
    return {'python':platform.python_version(),'system':platform.platform(),
        'run_at_unix':time.time(),'checks':tests(),'trace':trace_run(),
        'bad_summary':compress(TEXT,'bad'),'source':TEXT}
if __name__=='__main__':print(json.dumps(main(),ensure_ascii=False,indent=2))
Změnu modelu ověřte regresní sadou
Výměnu modelu posuzujte až proti stejné sadě otázek, podkladů, oprávnění a očekávaných výjimek. Oddělte jednoduché dotazy od dlouhých analýz a neřešitelných případů. Zaznamenejte i odmítnutí, neúplné výstupy a cenu opakovaných pokusů. Levnější model může být vhodný pro část práce, ale klasifikátor, který o směrování rozhoduje, potřebuje také ověření.
Novou variantu nepřebírejte jen proto, že medián klesl. Musí zachovat dohodnuté podmínky správnosti a ochrany dat. Pokud přidáte kompresor, jiný reranker a nový model současně, můžete porovnat celé řešení, ale nedokážete bez dalších běhů připsat změnu jedinému zásahu. Pro mechaniku slučování výsledků navazuje vysvětlení RRF; rychlejší řazení samo neověří pravdivost podkladu.
Praktickým prvním výstupem je jeden dohledatelný trace, rozdělení skutečných provozních časů a náklad na přijatou odpověď. Teprve nad nimi vyberte zásah, jeho vlastníka a podmínku návratu. Tento článek nezměřil produkční latenci, cenu inference ani úsporu. Ukázal spustitelný způsob, jak jednotlivé vrstvy nepomíchat a jak v malé demonstraci zachytit konkrétní vady.
Chcete zjistit, kde váš AI asistent ztrácí čas a rozpočet?
Pomohu vám vymezit problém, připravit zadání měření a domluvit přejímací podmínky s technickým týmem. Napište mi, při kterých úlohách dnes asistent zpomaluje práci. Rozsah diagnostiky a realizace potvrdíme předem; konkrétní úsporu je potřeba nejdřív ověřit. Do formuláře neposílejte důvěrné logy ani dokumenty.