
AI analýzu tabulky neověříte tím, že požádáte stejný model o přísnější kontrolu. Potřebujete znát význam sloupců, rozsah načtených dat a výpočet, který lze zopakovat. U grafu navíc musíte vidět skutečný obrázek: správně opsaná hodnota ještě neznamená správný výklad osy.
Praktický postup má tři oddělené části. Dohledání určí, který řádek odpovídá otázce. Výpočet zpracuje přesně vymezená data. Interpretace vysvětlí, co z výsledku plyne a co už ne. Jazykový model může pomoci ve všech třech, ale důkaz správnosti pokaždé vypadá jinak.
Určete otázku a správný jmenovatel
„Který kanál funguje nejlépe?“ není zadání pro výpočet. Může znamenat nejvíc poptávek, nejnižší náklad nebo nejvyšší podíl návštěv s poptávkou. Nejdřív vyberte jednu otázku a napište definici výsledku. Pak určete období, trh, jednotku jednoho řádku a pravidlo pro chybějící hodnoty.
Další články
V následující vlastní syntetické ukázce jeden řádek představuje souhrn návštěv a poptávek za dílčí segment. Předpokládáme nejvýše jednu poptávku na návštěvu; skutečná data by tuto podmínku potřebovala ověřit. Počítáme podíl poptávek na návštěvách pouze v úplných platných řádcích. Výsledek proto není konverzním poměrem celého webu ani výsledkem klienta.
Pokud potřebujete nejprve vybrat samotné marketingové ukazatele, navazuje měření dat v obsahovém marketingu. Tady řešíme užší problém: zda lze konkrétní číslo v AI výstupu reprodukovat ze vstupních dat.
Zkontrolujte typy dat a neúplné řádky
CSV není hotová datová databáze. Je to text s pravidly oddělování polí. Náš soubor používá středník, desetinnou čárku u nákladů a identifikátory s počátečními nulami. Na první pohled neškodné automatické převody mohou změnit identitu řádku nebo finanční hodnotu.
| ID | Kanál | Návštěvy | Poptávky | Náklad Kč |
|---|---|---|---|---|
| 001 | SEO | 100 | 10 | 1 250,50 |
| 002 | SEO | 900 | 9 | 2 000,00 |
| 003 | SEO | 200 | prázdné pole | 500,00 |
| 004 | PPC | 0 | 0 | 0,00 |
| 005 | PPC | sto | 2 | 300,00 |
| 006 | PPC | 50 | pole chybí | pole chybí |
Kontrola proběhla v Pythonu 3.14.9 pomocí standardních modulů csv a decimal, bez volání modelu. Import přes DictReader zachoval ID 001 jako text. Také návštěvy načetl jako text, nikoli automaticky jako čísla. Prázdné pole poptávek u 003 vrátilo prázdný řetězec; chybějící pole v krátkém řádku 006 hodnotu None. To odpovídá dokumentaci importu CSV.
Pro výpočet jsme vyřadili 003, 005 a 006. Chybějící poptávky jsme nedoplnili nulou a slovo „sto“ jsme tiše nepřepsali na 100. Je možné vytvořit jinou schválenou očistnou politiku, ale musí být vidět, které hodnoty mění a proč. Řádek 004 je platný nulový souhrn. Jeho vlastní podíl 0 děleno 0 je nedefinovaný, nikoli nula procent.
Rozlište hledání řádku od výpočtu
Otázka „Jaký náklad má ID 001?“ vyžaduje dohledat jednu buňku: 1 250,50 Kč. Otázka na společný podíl potřebuje zpracovat všechny přijaté řádky. Pokud aplikace jen vyhledá několik textových úryvků a předá je modelu, nemusí obsahovat celý jmenovatel. Plynulá odpověď to neprozradí.
Od nástroje proto chtějte počet importovaných řádků, použité filtry, vyřazené záznamy a skutečně spuštěný výpočet. Záhlaví „Analyzuji data“ není technický doklad. Ověřte také limity souboru, listy v sešitu a to, zda aplikace počítá nad daty, nebo pouze čte jejich náhled. Vložení screenshotu tabulky není rovnocenné předání CSV.
Přepočítejte čísla mimo jazykový model
Platné řádky 001, 002 a 004 obsahují celkem 1 000 návštěv a 19 poptávek. Společný podíl je 19 ÷ 1 000 × 100 = 1,9 %. Prostý průměr podílů dvou nenulových řádků, tedy 10 % a 1 %, vyjde 5,5 %. Je to chybná odpověď na otázku po společném podílu, protože každému řádku dává stejnou váhu navzdory různému počtu návštěv.
Součet nákladů přijatých řádků je 3 250,50 Kč. Částky jsou převedeny z textu na desetinný typ Decimal až po explicitním odstranění mezery a převodu desetinné čárky. Neznamená to, že stejná úprava bezpečně opraví všechny zahraniční exporty. Oddělovač tisíců a desetinných míst musí odpovídat datovému slovníku.
Následující celý příklad obsahuje i vstupní CSV a kontrolní podmínky. Uložte jej jako kontrola.py a spusťte pomocí python3 kontrola.py. Používá pouze standardní knihovnu, nepřistupuje k síti a nic nemění v původních datech.
Celý ověřený Python příklad (rozbalit)
import csv, io, json, platform
from decimal import Decimal

CSV = '''id;kanal;navstevy;poptavky;naklad_kc
001;SEO;100;10;1 250,50
002;SEO;900;9;2 000,00
003;SEO;200;;500,00
004;PPC;0;0;0,00
005;PPC;sto;2;300,00
006;PPC;50
'''

def check():
    rows = list(csv.DictReader(io.StringIO(CSV), delimiter=';'))
    assert rows[0]['id'] == '001'
    assert isinstance(rows[0]['navstevy'], str)
    assert rows[-1]['poptavky'] is None
    assert rows[2]['poptavky'] == ''
    valid, rejected = [], []
    for r in rows:
        try:
            n, p = int(r['navstevy']), int(r['poptavky'])
            cost = Decimal(r['naklad_kc'].replace(' ', '').replace(',', '.'))
            if n < 0 or p < 0 or p > n or cost < 0:
                raise ValueError('invalid range')
            valid.append((r['id'], n, p, cost))
        except (ValueError, TypeError, AttributeError):
            rejected.append(r['id'])
    n = sum(r[1] for r in valid)
    p = sum(r[2] for r in valid)
    rates = [Decimal(r[2]) / r[1] * 100 for r in valid if r[1] > 0]
    result = {
        'python': platform.python_version(),
        'input_rows': len(rows),
        'accepted_ids': [r[0] for r in valid],
        'rejected_ids': rejected,
        'visits_complete_rows': n,
        'leads_complete_rows': p,
        'weighted_percent': str(Decimal(p) / n * 100),
        'wrong_unweighted_percent': str(sum(rates) / len(rates)),
        'cost_complete_rows_CZK': str(sum(r[3] for r in valid)),
        'undefined_zero_visit_ids': [r[0] for r in valid if r[1] == 0],
    }
    assert (n, p, rejected) == (1000, 19, ['003', '005', '006'])
    assert result['weighted_percent'] == '1.900'
    assert Decimal(result['wrong_unweighted_percent']) == Decimal('5.5')
    assert result['cost_complete_rows_CZK'] == '3250.50'
    return result

if __name__ == '__main__':
    print(json.dumps(check(), ensure_ascii=False, indent=2))
V syntetické ukázce je chybou právě výměna váženého výsledku za průměr řádků. Není to zachycená odpověď konkrétního AI produktu. Test dokládá chování importu a kontrolního programu, nikoli úspěšnost modelu v datové analytice.
U grafu ověřte osu, jednotku a čitelnost
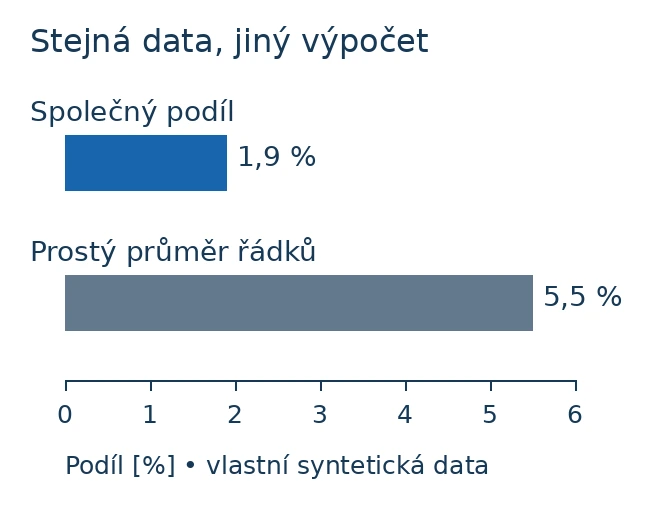
Správný výklad zní: na úplných platných řádcích vychází společný podíl 1,9 %. Chybný výklad zní: web konvertuje z 5,5 %. Druhá věta mění výpočet i rozsah závěru. Ani první věta nepovoluje doplnit vyřazené řádky nebo předpovídat obchodní výsledek.
Při kontrole cizího grafu nejprve přečtěte název, období, osy, jednotky a legendu. Zjistěte, zda osa začíná nulou, zda není logaritmická a zda je uveden zdroj. Pak porovnejte několik vytištěných hodnot s tabulkou. Přesná čísla neodhadujte z výšky sloupců, pokud nejsou k dispozici datové štítky nebo původní data.
Otevřete původní soubor i skutečné mobilní zobrazení. Celá stránka může mít správnou šířku, zatímco tabulka láme desetinná čísla. U širokých tabulek je vhodnější označená vodorovně posuvná oblast než zmenšení písma k nečitelnosti. Graf doplňte textovým výsledkem, aby důležitá informace nezůstala jen v barvě nebo pixelech.
Uložte reprodukovatelnou kontrolu
K reportu uchovejte původní export, jeho kontrolní součet, verzi skriptu, datový slovník, seznam vyřazených řádků a výstup. Pokud AI navrhla kód, uložte skutečně spuštěnou verzi, nikoli jen konverzaci. U dalšího exportu zopakujte stejná pravidla a změny zaznamenejte jako novou verzi metodiky.
Pro SEO GAP analýzu je taková stopa důležitější než další normalizované skóre bez vstupů. A při výpočtu SEO ROI přidejte i kontrolu předpokladů. Bez ní může být aritmetika přesná, ale rozhodnutí chybné.
Potřebujete z AI reportu udělat ověřitelný podklad?
Můžu s vámi vymezit rozhodovací otázku, kontrolní postup a hranice použití AI v marketingové analýze. Napište mi, které číslo dnes nedokážete dohledat ke vstupům. Případnou hlubší analytickou implementaci vymezíme podle rozsahu dat a odpovědnosti.